Contenu IA et pénalité Google : ce que dit vraiment la politique de Google
Google ne pénalise pas le contenu produit par une IA : il sanctionne le contenu inutile, quelle que soit son origine. Ce que disent exactement les règles anti-spam, ce qui fait réellement désindexer un site, et les cinq garde-fous d’un flux propre.
Publié le :
En bref
Non, Google ne pénalise pas le contenu généré par IA. Sa position publique, constante depuis 2023, est explicite : ce qui est évalué, c’est l’utilité du contenu pour le lecteur, pas l’outil qui l’a produit. Ce que Google sanctionne, et sévèrement, c’est l’abus de contenu à grande échelle sans valeur ajoutée, avec ou sans IA. La nuance est toute la différence entre un blog automatisé qui se classe et un site désindexé.
- La documentation officielle de Google indique que l’usage de l’IA n’est pas, en soi, contraire à ses règles : le critère est l’utilité du contenu.
- La politique anti-spam de mars 2024 vise l’« abus de contenu à grande échelle » : produire massivement des pages sans valeur, quelle que soit la méthode.
- Les sites désindexés après des campagnes d’articles IA partagent les mêmes causes : doublons d’intention, remplissage, sujets hors expertise, aucun contrôle qualité.
- Les garde-fous efficaces sont structurels : intention unique par page, sources vérifiables, dates réelles, maillage cohérent, contrôle bloquant avant publication.
Demander à l’IA de résumer cet article :
La position officielle de Google, sans interprétation
Google a clarifié sa position en février 2023 dans sa documentation Search Central (« AI-generated content and Google Search ») : l’automatisation, y compris par IA, n’est pas contraire aux règles lorsqu’elle produit du contenu utile ; elle l’est lorsqu’elle sert à manipuler les classements. Le système de « contenu utile » (helpful content) évalue le résultat, pas la méthode de production.
En mars 2024, Google a précisé ses règles anti-spam avec trois abus nommés : l’abus de contenu à grande échelle (scaled content abuse), l’abus de réputation de site (site reputation abuse) et l’abus de domaine expiré. Le premier est celui qui concerne l’auto-blogging : il vise la production massive de pages « sans valeur ajoutée pour les utilisateurs », quelle que soit la façon dont elles sont créées : la formulation couvre explicitement l’IA comme la sous-traitance humaine à bas coût.
Autrement dit : le mot « IA » n’apparaît dans aucune règle comme motif de sanction. Le mot « utile » apparaît partout. Un flux d’automatisation se juge donc exactement comme une équipe de rédacteurs : sur ce qu’il publie.
Ce qui est réellement sanctionné (et comment)
Deux mécanismes distincts peuvent toucher un site. Les systèmes algorithmiques (classement) dévalorisent progressivement les contenus jugés inutiles : le site perd des positions sans notification. Les actions manuelles, elles, sont notifiées dans Search Console et peuvent aller jusqu’à la désindexation de sections entières : c’est ce qui est arrivé publiquement à des sites ayant publié des centaines d’articles IA sans contrôle en 2024.
Dans les cas documentés de désindexation, les causes se répètent : des dizaines de pages qui visent la même intention et se cannibalisent, du texte qui tourne autour de la question sans y répondre, des sujets sans aucun rapport avec l’expertise du domaine (un site de cuisine qui publie sur les assurances), et aucune relecture ni contrôle qualité. Ce sont des défauts de flux, pas des défauts d’IA.
| Cause de sanction observée | Règle Google concernée | Garde-fou structurel |
|---|---|---|
| Pages massives sans valeur ajoutée | Scaled content abuse (mars 2024) | Une intention unique par page, vérifiée au plan |
| Doublons et cannibalisation d’intention | Systèmes de contenu utile | Contrôle de recouvrement avant rédaction |
| Texte de remplissage sans réponse | Systèmes de contenu utile | Réponse directe en tête, structure vérifiée |
| Sujets hors expertise du site | E-E-A-T (critères d’évaluation) | Plan borné au périmètre de l’offre et du secteur |
| Affirmations invérifiables, fausses dates | Politiques de fiabilité | Sources citées, dates de révision réelles |
| Publication sans aucun contrôle | Systèmes de contenu utile | Score qualité bloquant avant envoi CMS |
Les 5 garde-fous d’un flux d’automatisation propre
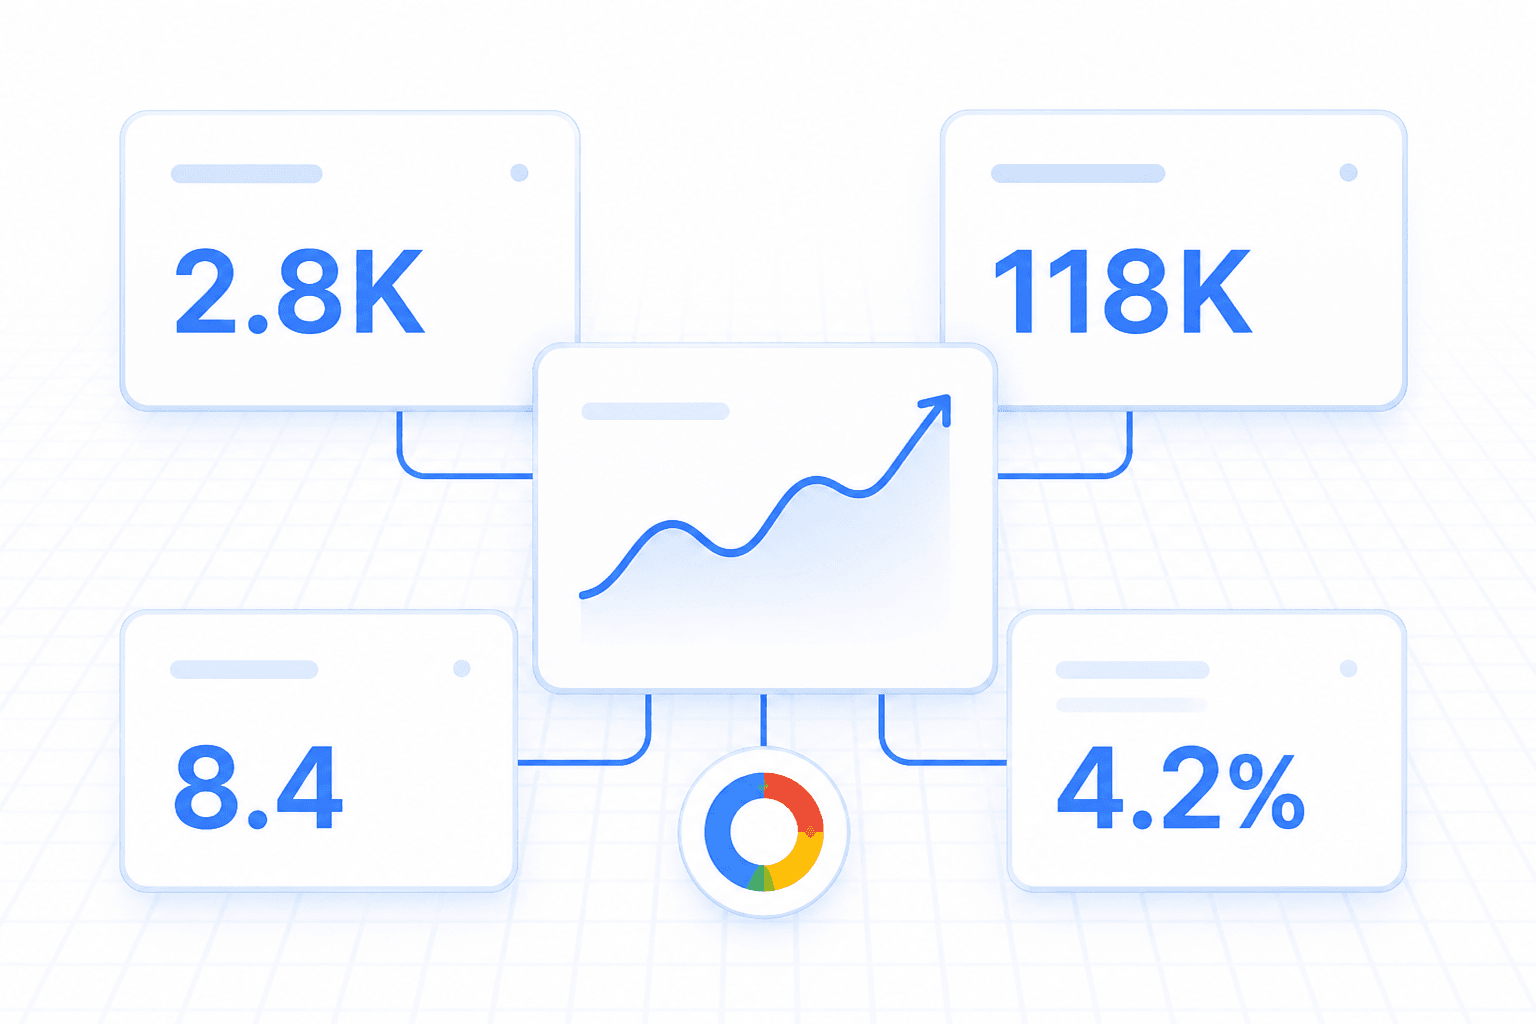
Premier garde-fou : le plan travaille par intention, pas par mot-clé. Chaque intention de recherche reçoit une page principale unique ; les requêtes voisines deviennent des sections ou des ancres. C’est la protection contre le scaled content abuse : impossible de produire cent pages vides quand chaque page doit couvrir une intention distincte du périmètre réel du site.
Deuxième : la structure de rédaction impose la réponse avant le développement, avec sources vérifiables et données datées. Troisième : le maillage interne est décidé au brief, ce qui interdit mécaniquement les pages orphelines. Quatrième : un contrôle qualité bloque la publication quand la structure, les sources ou les liens manquent : le score qualité de la rédaction SEO GetRerank joue ce rôle. Cinquième : les sujets sensibles (juridique, santé, promesses chiffrées) restent en validation humaine, comme détaillé dans automatiser sans perdre le contrôle.
Avec ces cinq garde-fous, un blog automatisé est structurellement plus conforme aux règles de Google que la moyenne des blogs manuels : les contrôles y sont systématiques au lieu de dépendre de la vigilance du jour.
- Une intention unique par page, vérifiée au plan
- Réponse directe, sources et dates réelles imposées
- Maillage décidé au brief, zéro orpheline
- Contrôle qualité bloquant avant publication
- Validation humaine sur les sujets sensibles
La checklist anti-risque avant de lancer l’autopilote
Avant d’activer une production automatisée, vérifiez ces points une fois : ils protègent ensuite chaque article publié. Le périmètre des sujets est borné à votre expertise réelle. Chaque catégorie a son réglage brouillon ou publication directe. Le contrôle de recouvrement d’intention est actif. Les pages produites affichent auteur, dates réelles et sources. Un audit technique tourne en continu pour détecter orphelines et liens cassés que la production pourrait créer.
Ensuite, surveillez deux signaux dans Search Console : la couverture d’indexation (une chute de pages indexées est le premier symptôme d’un problème de qualité perçue) et les impressions par page nouvelle. Un article utile commence à imprimer en quelques semaines ; une série d’articles qui n’imprime jamais mérite une revue du plan, pas un doublement du volume.
Et le volume ? Ce que « à grande échelle » veut dire
La règle de mars 2024 ne fixe aucun seuil de volume : « à grande échelle » qualifie l’abus, pas le nombre. Un site peut publier vingt articles utiles par mois sans risque, et se faire sanctionner pour vingt pages vides. Le volume soutenable est celui que votre cocon sémantique justifie : le nombre d’intentions réelles de votre marché, pas la capacité de production de l’outil.
C’est le vrai argument en faveur d’un système qui chaîne recherche sémantique, brief et rédaction : comme décrit dans la méthode complète d’automatisation : le volume découle du plan, jamais l’inverse.
Questions fréquentes
Google peut-il détecter qu’un texte a été écrit par une IA ?
La question n’a pas d’enjeu pratique : Google déclare évaluer l’utilité du contenu, pas son origine, et ne demande pas de déclarer l’usage d’une IA. Un texte utile, sourcé et structuré est traité comme tel : un texte vide aussi, qu’il soit humain ou généré.
Faut-il indiquer sur son site que les articles sont générés par IA ?
Google ne l’exige pas pour le classement. En revanche, afficher un auteur réel (une équipe identifiable), des dates sincères et des sources vérifiables est fortement recommandé : ce sont des signaux de fiabilité évalués par les critères E-E-A-T, IA ou pas.
Un site déjà sanctionné pour du contenu IA peut-il récupérer ?
Oui, en traitant la cause : supprimer ou fusionner les pages sans valeur et les doublons d’intention, réécrire les pages conservées selon une structure utile, puis, en cas d’action manuelle, soumettre une demande de réexamen dans Search Console. La récupération se mesure en semaines ou mois selon l’ampleur.
Publier 100 articles d’un coup est-il risqué ?
Le risque ne vient pas du nombre mais de la justification : 100 pages couvrant 100 intentions réelles et distinctes de votre marché sont légitimes ; 100 variations de la même requête sont un abus de contenu à grande échelle. Un rythme régulier reste préférable : il lisse aussi la mesure et la validation.
La prochaine étape
Appliquez cette méthode à votre site, puis mesurez le même périmètre chaque semaine.
Partager
À propos de l’auteur
Contenu écrit et vérifié par l’équipe GetRerank, à partir de données produit réelles et de sources publiques citées dans l’article. Aucun résultat client n’est utilisé comme preuve.