Claude Fable 5.1 vs Claude Opus 5 : lequel choisir pour produire du contenu SEO/GEO en 2026 ?
Anthropic recommande Opus 5 par défaut. Écarts de benchmarks, coût par article calculé, rétention des données : le comparatif chiffré pour choisir sans payer deux fois trop cher.
Publié le :

 Claude Fable 5.1Analyse de la documentation Anthropic
En bref
Cet article s’adresse à vous si vous produisez du contenu à l’échelle et que vous devez trancher entre deux modèles Claude dont le prix par token diffère d’un facteur deux. Il ne vous explique pas comment prompter, mais vous donne l’arbitrage : les écarts réellement mesurés sur les épreuves de travail de connaissance, le coût par article calculé sur des hypothèses explicites, et trois différences contractuelles que les benchmarks ne montrent pas. Pour la fiche complète du modèle et ses ruptures d’API, voir Claude Fable 5.1 : ce qui change vraiment.
- Opus 5 pour 90 % de la production, Fable 5.1 pour la recherche et les pages à fort enjeu. C’est ce que recommande Anthropic dans sa propre documentation.
- Sur le travail de connaissance, l’écart mesuré est de 1,6 % pour un prix par token double. Sur la recherche agentique, il est de 23,6 points.
- Le coût par article de fond : environ 0,73 $ sur Opus 5 contre 1,30 $ sur Fable 5.1, soit 78 % de plus et non le double, parce que le cache compense.
- Trois différences non mesurables par un benchmark : la rétention des données, l’étendue des classifieurs de sécurité, et l’absence de Priority Tier.
- La bonne question n’est pas « lequel choisir » mais « comment router » : Fable 5.1 lit les blocs de raisonnement d’Opus 5, l’inverse n’est pas vrai.
Demander à l’IA de résumer cet article :
La réponse courte
Opus 5 pour 90 % de votre production, Fable 5.1 pour la recherche et les pages à fort enjeu. Sur le travail de connaissance, l’écart mesuré entre les deux est de 1,6 %, pour un prix par token deux fois supérieur. Sur les tâches longues et outillées, en revanche, Fable 5.1 creuse franchement l’écart.
Ce n’est pas un avis contrarien : c’est ce que recommande Anthropic dans sa propre documentation.
Ce que recommande Anthropic, noir sur blanc
La documentation développeur de Claude Platform, sur sa page de nouveautés de Fable 5.1, indique de commencer par Claude Opus 5 pour la plupart des charges de travail, et de n’utiliser Fable 5.1 que pour du raisonnement exigeant et du travail agentique long horizon, ou quand vos évaluations sur Opus 5 à effort supérieur restent insuffisantes.
C’est inhabituel. Un éditeur qui sort son modèle le plus capable et qui vous dit de commencer par le précédent, moins cher, vous donne une information que le marketing ne donne pas. Prenez-la au sérieux : elle vient de l’entreprise qui a le plus de données sur les deux modèles.
Un partenaire d’accès anticipé le formule autrement. Cognition, qui édite Devin, annonce basculer son trafic Opus 5 vers Fable 5.1 le jour du lancement, mais précise que c’est le nouveau tarif des lectures de cache qui rend enfin un modèle de cette classe économique sur les charges qu’ils gardaient sur Opus. Autrement dit, l’arbitrage s’est déplacé par le prix, pas par la capacité.
Les benchmarks qui comptent pour le contenu
La plupart des comparatifs publiés reprennent les scores de codage, qui n’ont aucun rapport avec la production éditoriale. Voici les épreuves pertinentes. Tous ces chiffres sont auto-déclarés par Anthropic, mesurés avec les garde-fous de production activés, et publiés dans l’annonce du 1er septembre 2026.
La forme de ce tableau raconte tout. Sur les tâches ponctuelles, y compris le travail de connaissance, l’écart est dans le bruit de mesure. Sur les tâches longues, autonomes et outillées, il devient énorme. Anthropic précise d’ailleurs que l’écart se creuse aux niveaux d’effort les plus élevés.
Une précision méthodologique qui protège votre crédibilité si vous citez ces chiffres : sur l’épreuve de recherche scientifique agentique, Anthropic indique une erreur type de 3,5 à 4,5 points par modèle et publie à la fois les scores du classement public et ceux de son propre dispositif. Un écart de 1,4 point sur l’épreuve de raisonnement, lui, n’est pas significatif.
| Épreuve | Fable 5.1 | Opus 5 | Écart | Lecture |
|---|---|---|---|---|
| Travail de connaissance (GDPval-AA v2, Elo) | 1853 | 1824 | +29 pts, soit +1,6 % | Quasi équivalent |
| Raisonnement, HLE avec outils | 65,0 % | 63,6 % | +1,4 pt | Quasi équivalent |
| Raisonnement, HLE sans outils | 60,9 % | 56,6 % | +4,3 pts | Avantage net |
| Workflows métier (AutomationBench) | 31,4 % | 26,9 % | +4,5 pts | Avantage net |
| Recherche scientifique agentique (Terminal-Bench-Science 0.1) | 52,6 % | 29,0 % | +23,6 pts | Écart massif |
| Codage agentique (Terminal-Bench 4.0) | 55,8 % | 52,3 % | +3,5 pts | Avantage modéré |
| Usage d’ordinateur (OSWorld 2.0, strict) | 41,7 % | 39,6 % | +2,1 pts | Quasi équivalent |
Le prix réel : le coût par article, pas le prix par token
Le prix affiché induit en erreur, parce que la structure de coût a changé. Le point contre-intuitif est la ligne des lectures de cache : celles de Fable 5.1 coûtent moitié moins que celles d’Opus 5, en valeur absolue. Sur Fable 5.1, une lecture de cache vaut 0,025 fois le prix d’entrée de base, contre 0,1 sur les autres modèles Claude.
Anthropic chiffre l’effet global à environ 25 % d’économie contre Fable 5 sur une charge typique, et jusqu’à environ 45 % sur une charge très agentique, mesuré sur quatre semaines d’usage réel en août 2026.
| Poste | Fable 5.1 | Opus 5 | Rapport |
|---|---|---|---|
| Entrée | 10 $ | 5 $ | ×2 |
| Sortie | 50 $ | 25 $ | ×2 |
| Écriture de cache 5 min | 12,50 $ | Non publié ici | Non comparable |
| Écriture de cache 1 h | 20 $ | Non publié ici | Non comparable |
| Lecture de cache | 0,25 $ | 0,50 $ | ×0,5 |
| Traitement par lot | 5 $ / 25 $ | 2,50 $ / 12,50 $ | ×2 |
Le calcul sur un article
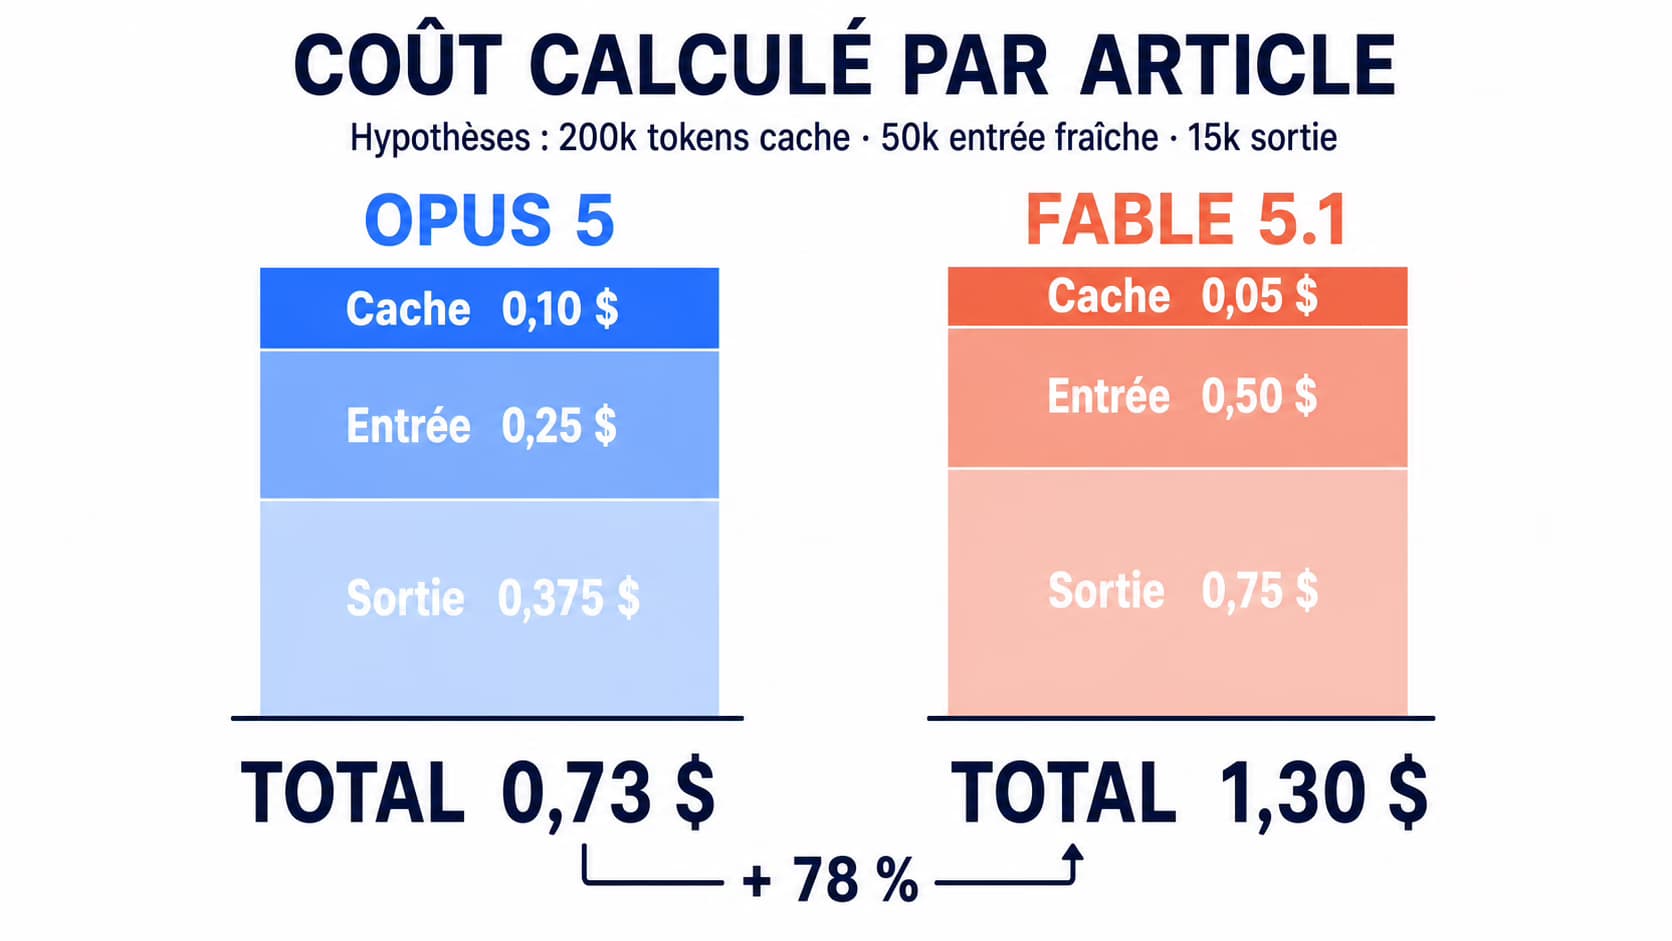
Prenez vos propres chiffres, mais voici la méthode. Hypothèses pour un article de fond avec recherche : 250 000 tokens d’entrée cumulés sur la session, dont 200 000 en lectures de cache et 50 000 en entrée fraîche, et 15 000 tokens de sortie.
Sur Opus 5 : 200 000 lectures à 0,50 $ le million font 0,10 $, plus 50 000 entrées à 5 $ le million font 0,25 $, plus 15 000 sorties à 25 $ le million font 0,375 $. Total d’environ 0,73 $. Sur Fable 5.1 : 200 000 lectures à 0,25 $ le million font 0,05 $, plus 50 000 entrées à 10 $ le million font 0,50 $, plus 15 000 sorties à 50 $ le million font 0,75 $. Total d’environ 1,30 $.
Environ 78 % plus cher, pas le double, parce que le cache compense partiellement. Sur 100 articles par mois, l’écart est d’environ 57 $. Autrement dit : à ce volume, le choix du modèle n’est pas un enjeu budgétaire, c’est un enjeu de qualité. L’arbitrage devient financier à partir de plusieurs milliers d’articles ou de boucles agentiques longues, où le poste sortie explose. Notre article sur le coût réel d’un article SEO pose le même calcul à l’échelle d’une année de production.
Deux effets à ne pas oublier dans votre calcul. Fable 5.1 réécrit plus souvent des fichiers entiers au lieu de faire une édition ciblée, et à 50 $ le million de tokens de sortie, c’est le poste qui dérape. À l’inverse, plusieurs partenaires rapportent des économies sur d’autres tâches : Rogo mesure une précision équivalente à Fable 5 avec 20 % de tokens en moins, et Every rapporte environ deux fois la vitesse d’Opus 5 pour moitié moins de tokens sur ses tests. Ces chiffres sont des retours clients rapportés par Anthropic, pas des mesures indépendantes.
Trois différences qui n’ont rien à voir avec la performance
Ce sont souvent elles qui décident, et aucun benchmark ne les montre.
La rétention des données. Sur ce point, les deux sources officielles d’Anthropic ne se recoupent pas, et notre analyse du modèle détaille la divergence plutôt que de trancher. Ce qui suit reprend la documentation développeur, la plus contraignante des deux. Opus 5 y est disponible sous accord de zéro rétention. Fable 5.1 et Mythos 5.1 imposent une rétention de 30 jours et ne sont pas disponibles en zéro rétention sauf autorisation expresse d’Anthropic ; ce sont des Covered Models. Sur l’API Claude, une requête émise depuis une organisation sans rétention 30 jours renvoie une erreur 400. Anthropic déploie un dispositif appelé Enterprise Frontier Safeguards, qui rétablit une confidentialité équivalente en stockant les données chez le client, par phases à partir de l’automne 2026. Si vous êtes agence avec des clients en secteur régulé, vérifiez ce point avant tout le reste.
Les classifieurs de sécurité. Opus 5 n’exécute que des classifieurs cybersécurité. Fable 5.1 en exécute un ensemble plus large : attendez-vous à des catégories de refus au-delà du cyber, notamment la biologie et l’extraction de raisonnement. Anthropic annonce environ 60 % de déclenchements en moins par session dans Claude Code et 85 % de déclenchements en moins sur les questions bénignes de biologie et de médecine, mais certaines catégories restent redirigées vers les modèles Opus. Pour du contenu éditorial généraliste, l’impact est faible ; pour un site santé ou sécurité informatique, il est réel.
Le Priority Tier. Ni Fable 5.1 ni Mythos 5.1 ne sont supportés sur Priority Tier. Fable 5 l’est. Si vous dépendez d’une capacité garantie aux heures de pointe, c’est un critère éliminatoire.
- Rétention : 30 jours sur Fable 5.1, zéro rétention sur Opus 5
- Classifieurs : plus larges sur Fable 5.1, cyber seul sur Opus 5
- Priority Tier : absent sur Fable 5.1, présent sur Fable 5
- Erreur 400 si votre organisation est en zéro rétention
Le tableau de décision
Cette grille suppose que vous mesuriez sur vos propres cas avant de basculer une charge en production. Elle applique la recommandation d’Anthropic plutôt que le réflexe du modèle le plus récent.
| Votre situation | Modèle | Pourquoi |
|---|---|---|
| Rédaction sur brief avec sources fournies | Opus 5 | Écart de 1,6 % sur le travail de connaissance, prix par token divisé par deux |
| Volume élevé, production hebdomadaire régulière | Opus 5 | Le poste sortie décide à l’échelle |
| Recherche multi-étapes, veille, synthèse de corpus | Fable 5.1 | Plus de 23 points sur la recherche agentique, meilleur ancrage dans les sources primaires |
| Page à fort enjeu avec guide de style de marque strict | Fable 5.1 | Adhérence rédactionnelle citée comme point saillant par les partenaires |
| Client en secteur régulé exigeant le zéro rétention | Opus 5 | Fable 5.1 impose 30 jours de rétention jusqu’au déploiement d’EFS |
| Besoin de capacité garantie en heure de pointe | Opus 5 ou Fable 5 | Fable 5.1 n’est pas sur Priority Tier |
| Chaîne agentique longue, dizaines d’appels d’outils | Fable 5.1 | Lectures de cache à moitié prix d’Opus 5, l’économie s’accumule |
| Vos évaluations sur Opus 5 en effort élevé échouent | Fable 5.1 | C’est le critère de bascule recommandé par Anthropic |
Quand Fable 5.1 se justifie vraiment pour du contenu
Trois cas, et seulement trois.
Le premier est la phase de recherche. C’est là que l’écart est le plus large et le plus utile. Samaya, partenaire d’accès anticipé, rapporte sur son propre référentiel financier un gain net et attribue la différence à la capacité du modèle à creuser des sources primaires plutôt que de s’appuyer sur la couverture secondaire. Pour un article qui doit citer des chiffres exacts, cette différence vaut plus que n’importe quel score global.
Le deuxième est la conformité à un guide de style strict. Canva cite la qualité d’écriture comme le point saillant du modèle et une meilleure adhérence à ses consignes rédactionnelles en tests à l’aveugle. Si votre marque a un guide de style précis et que vous passez du temps à corriger le ton, c’est l’argument le plus solide.
Le troisième est la boucle agentique longue : analyse de corpus, traitement de dizaines de documents, recherche qui s’auto-relance. Là, le tarif des lectures de cache inverse l’arbitrage économique et Fable 5.1 peut coûter moins cher qu’Opus 5 sur la tâche complète.
Hors de ces trois cas, Opus 5 est le bon choix par défaut, et ce n’est pas une position de repli. Les réglages de prompt et les régressions rédactionnelles à corriger sont détaillés dans utiliser Fable 5.1 pour le SEO et le GEO.
La vraie réponse : router, pas choisir
La question « lequel choisir » est mal posée. Les deux modèles partagent la même API Messages, la même fenêtre d’un million de tokens, la même limite de 128 000 tokens de sortie et le même tokenizer. Basculer de l’un à l’autre demande un changement d’identifiant de modèle et une poignée d’ajustements, détaillés dans notre guide de migration vers Fable 5.1.
Le bon montage est donc un routage par étape : Fable 5.1 sur la recherche et les pages sensibles, Opus 5 sur le reste. Un détail technique rend ce routage propre : Fable 5.1 lit les blocs de raisonnement produits par Opus 5, ce qui permet de démarrer une session sur Opus et de la faire monter sur Fable sans perdre le contexte de raisonnement. L’inverse n’est pas vrai : Opus 5 ne peut pas lire les blocs de Fable 5.1, et l’API les retire silencieusement.
C’est exactement le principe du routage que GetRerank applique dans son flux : le modèle est choisi par étape selon la complexité, pas par abonnement. Analyse du site, plan de contenu, rédaction, maillage, publication CMS et mesure de Google et des six moteurs IA avancent dans la même chaîne, sans que vous ayez à arbitrer modèle par modèle sur chaque article.
La méthode générale de comparaison d’outils est dans bien comparer deux outils SEO ou GEO.
Sources et méthode de vérification
Publications officielles Anthropic, vérifiées le 2 septembre 2026 : l’annonce Fable 5.1 et Mythos 5.1 avec son tableau de benchmarks et les retours partenaires, la page de nouveautés de Fable 5.1 pour les tarifs et les différences de comportement, le guide de migration pour les écarts de tarif, de rétention et de classifieurs, la vue d’ensemble des modèles, et la note Enterprise Frontier Safeguards.
Presse : MacRumors et 9to5Mac du 1er septembre 2026. Retours partenaires cités dans l’annonce Anthropic, non vérifiés indépendamment : Cognition, Samaya, Canva, Rogo, Every, Millennium, Browserbase.
Le calcul de coût par article ci-dessus applique les tarifs officiels à des hypothèses de volume que nous énonçons explicitement. Ce n’est pas une mesure, c’est une méthode à refaire avec vos propres chiffres.
Questions fréquentes
Fable 5.1 est-il deux fois meilleur qu’Opus 5 puisqu’il coûte deux fois plus cher ?
Non. Sur le travail de connaissance, l’écart auto-déclaré est de 1,6 %. Sur la recherche agentique, il est de 23,6 points, soit près du double. Le rapport qualité-prix dépend entièrement du type de tâche : sur de la rédaction, le surcoût ne se justifie pas ; sur de la recherche longue, il se justifie largement.
Est-ce que le nouveau tarif de cache rend Fable 5.1 moins cher qu’Opus 5 ?
Sur certaines charges, oui. Les lectures de cache coûtent 0,25 $ le million sur Fable 5.1 contre 0,50 $ sur Opus 5. Dans une session très agentique où les lectures de cache dominent la facture, Fable 5.1 peut sortir moins cher sur la tâche complète. Sur un article rédigé en une passe, où le poste sortie domine, il reste plus cher.
Puis-je utiliser les deux dans la même conversation ?
Oui, dans un sens. Fable 5.1 lit les blocs de raisonnement d’Opus 5, donc une conversation peut monter d’Opus 5 vers Fable 5.1 en conservant son raisonnement. Dans l’autre sens, Opus 5 ne peut pas lire les blocs de Fable 5.1 : l’API les supprime avant l’appel, sans facturation, et le modèle cible replanifie sans ce raisonnement, ce qui peut augmenter le coût et la latence du premier tour après la bascule.
Faut-il rester sur Fable 5 plutôt que passer à Fable 5.1 ?
Rarement. À prix d’entrée et de sortie identiques, Fable 5.1 est supérieur sur toutes les épreuves publiées et ses lectures de cache coûtent quatre fois moins cher. Le seul motif de rester est le Priority Tier, supporté sur Fable 5 et pas sur Fable 5.1, ou une intégration qui utilise le forçage d’appel d’outil et que vous ne pouvez pas modifier tout de suite.
La prochaine étape
Appliquez cette méthode à votre site, puis mesurez le même périmètre chaque semaine.
Partager
À propos de l’auteur
Contenu écrit et vérifié par l’équipe GetRerank, à partir de données produit réelles et de sources publiques citées dans l’article. Aucun résultat client n’est utilisé comme preuve.