Claude Fable 5.1 pour le SEO et le GEO : produire du contenu qui ranke dans Google et dans les réponses IA
Watermark statistique, prose plus dense, citations non marquées : ce que Claude Fable 5.1 change pour votre contenu SEO et GEO, avec les réglages d’effort et les prompts correctifs.
Publié le :
 Claude Fable 5.1Analyse de la documentation Anthropic
En bref
Cet article s’adresse à vous si vous produisez du contenu à l’échelle et que vous avez accès à Claude Fable 5.1, sorti le 1er septembre 2026. Il ne traite pas de ce qu’est le modèle, mais de trois choses concrètes : ce que Fable 5.1 fait mieux que ses prédécesseurs sur du contenu éditorial, les trois régressions rédactionnelles documentées par Anthropic qu’il faut corriger par prompt, et le fait que tout texte qu’il génère porte désormais un watermark statistique. Si vous cherchez d’abord à savoir si le modèle vaut son prix, allez plutôt voir le comparatif Claude Fable 5.1 vs Claude Opus 5. Pour la fiche complète du modèle, voir Claude Fable 5.1 : ce qui change vraiment.
- Tout texte produit par Fable 5.1 et Mythos 5.1 porte le watermark statistique d’Anthropic, sur toutes les plateformes. Ce n’est pas désactivable.
- Trois régressions rédactionnelles documentées : prose plus dense, formatage réduit en conversation, et citations non marquées lors des résumés de documents.
- La régression la plus sérieuse est la troisième : un résumé peut reprendre un passage source quasi mot pour mot, sans guillemets, dans un article publié sous votre nom.
- À effort bas, le modèle répond de mémoire plutôt que d’appeler un outil de recherche. Pour du contenu qui doit être frais, c’est une régression majeure.
- Sur le travail de connaissance, l’écart mesuré avec Opus 5 est de 1,6 % pour un prix par token double. Anthropic recommande de commencer par Opus 5.
Demander à l’IA de résumer cet article :
Ce que Fable 5.1 change pour la production de contenu
Trois choses, et une seule est une amélioration franche. D’abord le travail sur documents, tableurs et présentations progresse nettement, ainsi que la recherche multi-étapes. Ensuite le coût baisse : les lectures de cache passent de 1 $ à 0,25 $ par million de tokens, soit 75 % de moins, ce qui donne environ 25 % d’économie sur une charge typique et jusqu’à 45 % sur du travail très agentique.
Enfin, et c’est le point que la plupart des reprises ont sauté, la documentation développeur d’Anthropic liste sept différences de comportement par défaut par rapport à Fable 5. Quatre concernent directement l’écriture, et trois de ces quatre sont des régressions du point de vue d’un rédacteur. Elles ne sont pas des bugs : ce sont des choix de modèle qui se corrigent par prompt, à condition de savoir qu’ils existent.
Un avertissement à lire avant tout le reste : Anthropic recommande explicitement de commencer par Claude Opus 5 pour la plupart des charges de travail, et de ne passer à Fable 5.1 que pour du raisonnement exigeant, du travail agentique long horizon, ou quand vos évaluations sur Opus 5 à effort élevé restent insuffisantes. Pour de la rédaction SEO standard, cette recommandation s’applique pleinement.
Le point que personne ne mentionne : tout texte généré est watermarké
Tout texte produit par Claude Fable 5.1 et Claude Mythos 5.1 porte le watermark statistique d’Anthropic, sur toutes les plateformes où le modèle est disponible. Ce n’est pas une option, ce n’est pas désactivable, et ça concerne directement quiconque publie du contenu généré.
Ce que dit exactement Anthropic
Le watermark découle d’une obligation légale. En juillet 2026, Anthropic a signé, avec 190 autres signataires, le Code de bonnes pratiques de l’EU AI Act sur la transparence des contenus générés par IA. Ce code impose un watermark sur les sorties des modèles publiés après le 2 août 2026.
C’est une méthode statistique : elle donne une probabilité que Claude ait participé à la rédaction d’un texte, pas une preuve binaire. Elle n’ajoute aucun token ni caractère caché, et ne change ni le sens, ni la qualité, ni la lisibilité de la sortie. Elle ne contient aucune information sur vous, votre organisation ou vos conversations.
Elle est invisible sans l’API de détection, qu’Anthropic déploie en préversion privée. L’accès à cette API est actuellement réservé à des organisations éligibles : régulateurs, forces de l’ordre, médias, fact-checkers, chercheurs indépendants, organismes éducatifs, groupes de la société civile européenne, et entreprises soumises à la même obligation de conformité. Les fichiers image et vidéo produits par Claude portent en plus des Content Credentials C2PA signés, quand vous les récupérez via l’API Files.
- Méthode statistique, pas une preuve binaire
- Aucun token ni caractère caché ajouté
- Aucune information sur vous ni votre organisation
- Détection en préversion privée, accès restreint
Ce que ça implique concrètement pour votre contenu
Trois conséquences, dans l’ordre de ce qui doit vous inquiéter le moins au plus.
Pour Google, rien ne change. Google ne pénalise pas le contenu généré par IA en tant que tel, il sanctionne le contenu inutile quelle qu’en soit l’origine. Le watermark ne crée aucun signal exploitable par Googlebot : il n’y a pas de caractère caché à détecter et l’accès à la détection est restreint. Notre article sur contenu IA et pénalité Google détaille ce que disent réellement les règles anti-spam.
Pour vos clients et vos appels d’offres, ça change. Si vous êtes agence et que votre contrat stipule une rédaction humaine, un donneur d’ordre soumis à l’EU AI Act peut, en théorie, faire vérifier. Le pragmatisme consiste à ne pas signer de clause que votre flux de production contredit, plutôt qu’à parier sur l’indétectabilité.
Pour votre positionnement, c’est une opportunité. La transparence sur votre flux devient un argument plutôt qu’un risque, et elle correspond exactement à ce que le E-E-A-T récompense : dire qui a écrit, qui a vérifié, et sur quelles sources.
Trois régressions rédactionnelles à corriger par prompt
Ces trois comportements sont documentés par Anthropic dans la section de sa documentation qui liste ce qui change par rapport à Claude Fable 5. Aucun ne nécessite de changement de code, tous nécessitent un changement de prompt.
Régression 1 : la prose est plus dense
Anthropic écrit que dans certains cas, la prose de Fable 5.1 est plus dense que celle de Fable 5, avec des phrases plus longues et moins de sauts de paragraphe. Pour du contenu web, c’est un problème direct : la densité tue la lisibilité mobile et réduit l’extractibilité par les moteurs génératifs, qui reprennent des passages courts et autonomes.
Le correctif dans votre prompt système : imposer une contrainte structurelle chiffrée plutôt qu’une consigne de style. Par exemple « phrases de 20 mots maximum, un paragraphe égale une idée et trois phrases maximum, un saut de ligne tous les deux paragraphes ». Une consigne quantifiée est suivie ; « écris de façon aérée » ne l’est pas.
Régression 2 : le formatage en conversation est réduit
Le modèle utilise moins le gras, les titres et les listes que les Claude précédents. Anthropic prévient d’un effet de bord vicieux : les règles anti-formatage écrites pour les modèles antérieurs peuvent maintenant supprimer la structure dont le contenu a besoin.
Si votre prompt système contient une ligne du type « n’utilise pas de listes à puces » ou « évite les titres inutiles », héritée d’un réglage fait sur Sonnet ou Opus, retirez-la. Elle s’additionne au nouveau comportement par défaut et vous obtenez des blocs de texte sans aucune structure, c’est-à-dire l’inverse de ce qu’un moteur génératif sait extraire.
Régression 3 : les citations ne sont pas marquées, et c’est le vrai risque
C’est la régression la plus sérieuse pour quiconque produit du contenu. Anthropic le formule sans ambiguïté : quand il résume des documents, le modèle est plus susceptible de reproduire des passages de la source sans les marquer comme des citations.
Traduit en risque métier : si votre flux consiste à donner des sources à Claude et à lui demander une synthèse, vous pouvez vous retrouver avec des phrases reprises quasi mot pour mot d’un concurrent, dans un article publié sous votre nom, sans guillemets. C’est un risque de contenu dupliqué et un risque juridique, pas un problème de style.
Trois garde-fous. Exiger dans le prompt que toute reprise littérale soit entre guillemets avec la source nommée, et que le reste soit reformulé intégralement. Ajouter une étape de contrôle de similarité automatisée entre le brouillon et les sources fournies : c’est la seule protection fiable, le prompt ne suffit pas. Et ne jamais publier un résumé de source unique sans relecture, car plus l’article repose sur une seule source, plus le risque est élevé.
- Guillemets et source nommée exigés dans le prompt
- Contrôle de similarité automatisé contre les sources
- Relecture obligatoire sur les résumés de source unique
- Le prompt seul ne suffit pas, c’est un défaut par défaut
Le piège du faible effort pour le contenu qui doit être frais
À effort bas, Fable 5.1 répond de mémoire plus souvent que Fable 5, au lieu d’appeler un outil de recherche. Pour du contenu d’actualité ou toute page qui doit citer des chiffres récents, c’est une régression majeure : le modèle produira un article fluide et daté, sans le signaler.
Deux réglages, selon votre architecture. Soit vous montez l’effort pour les requêtes qui ont besoin d’information fraîche, soit vous dites explicitement au modèle quand chercher. Sur Fable 5.1, vous pouvez même changer l’effort en cours de conversation via un message système portant uniquement la configuration de sortie, sans invalider le cache de prompt. C’est utile pour un flux qui alterne recherche coûteuse et rédaction routinière.
À noter : l’effort par défaut n’est pas le même partout. Fable 5.1 tourne en effort élevé par défaut dans Claude Code, et en effort moyen dans Claude Cowork et sur Claude.ai. Si vous comparez une sortie obtenue dans l’interface et une sortie obtenue par API, vous ne comparez pas la même configuration.
Le réglage d’effort : où se joue le coût réel
Cinq niveaux existent : bas, moyen, élevé qui est le défaut de l’API, très élevé et maximal. Anthropic précise que les gains de Fable 5.1 sur Fable 5 sont les plus marqués aux deux niveaux supérieurs, mais que ces niveaux ajoutent du temps de réflexion et allongent le délai avant première réponse.
La règle qu’Anthropic répète : ne reprenez pas un réglage d’effort calibré pour Fable 5, refaites un balayage sur vos propres évaluations. Un effort mal réglé coûte plus cher qu’un mauvais choix de modèle.
| Tâche éditoriale | Effort conseillé | Pourquoi |
|---|---|---|
| Reformulation, métadonnées, variantes de titres | Bas | Aucun besoin de recherche ni de raisonnement long |
| Rédaction sur brief complet et sources fournies | Moyen | Le contrôle du coût le plus rentable, à tester en priorité |
| Article de fond avec recherche multi-étapes | Élevé | Défaut de l’API, le bon compromis pour la majorité du travail |
| Analyse de corpus long, synthèse de rapports | Très élevé | Le gain se voit sur le raisonnement long contexte |
| Tâche où vos évaluations sur Opus 5 échouent | Maximal | Réservé aux cas sensibles à la capacité, pas au volume |
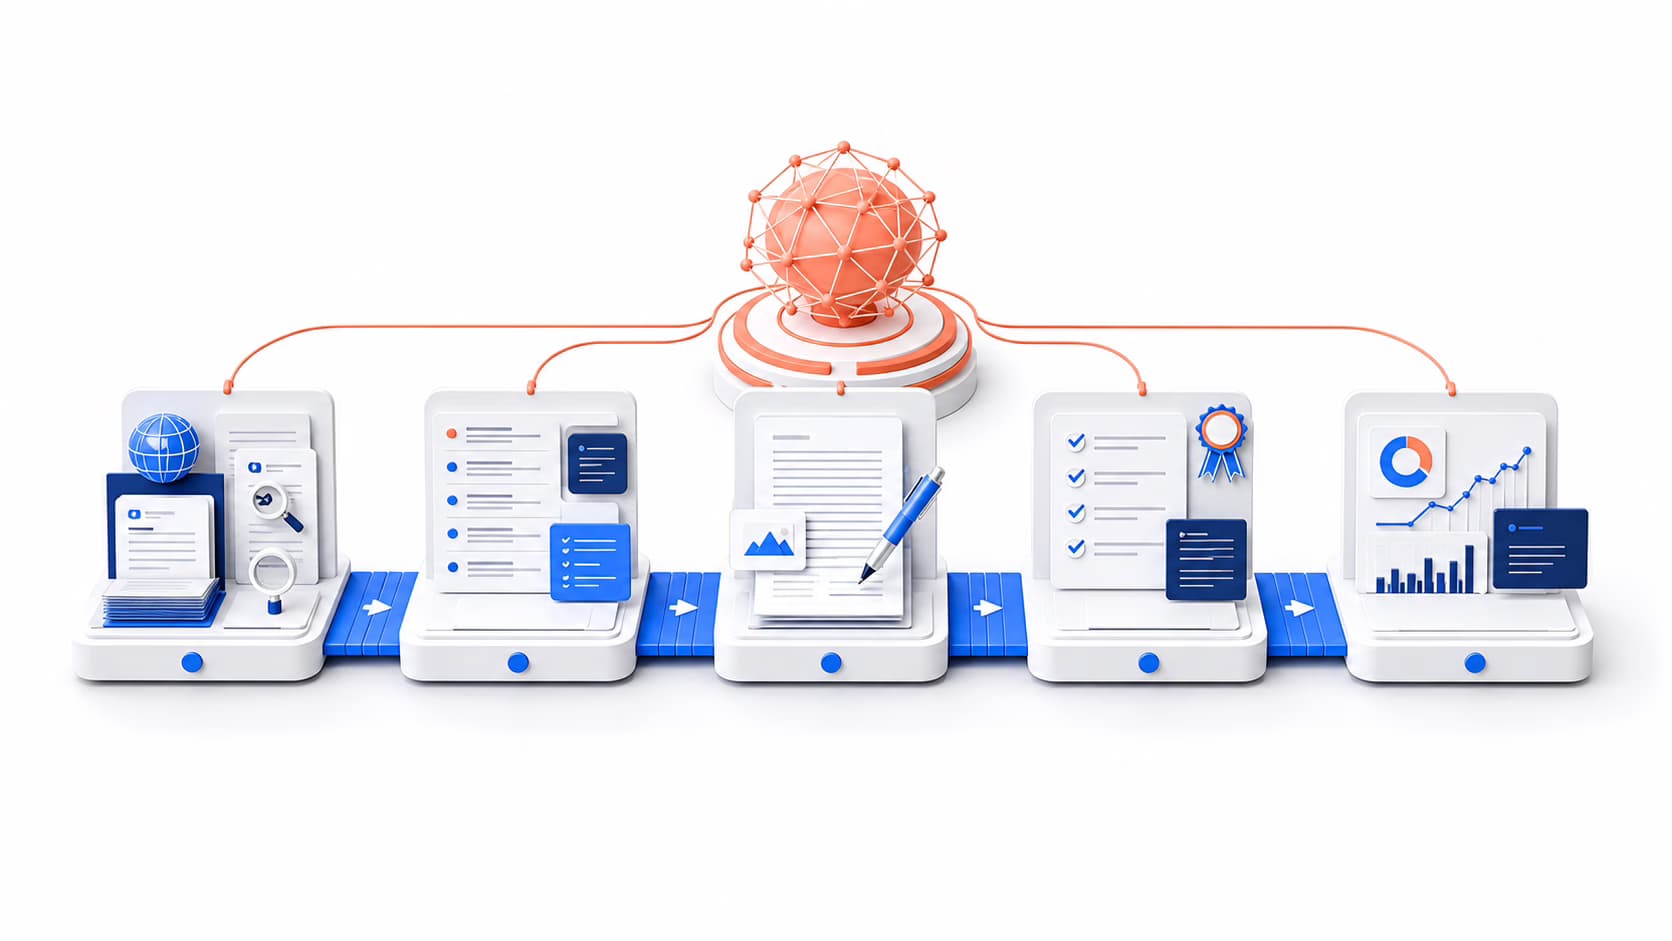
Un flux en cinq étapes pour un article SEO et GEO
Voici le flux que nous recommandons, avec le routage explicite entre modèles. Le principe : ne payez le modèle cher que là où il apporte quelque chose.
Étape 1, recherche et collecte de sources, avec Fable 5.1 à effort élevé ou très élevé. C’est là qu’il justifie son prix : la recherche multi-étapes et l’ancrage dans des sources primaires progressent nettement. Un partenaire d’accès anticipé, Samaya, rapporte que sur une question de résultats financiers le modèle est allé directement à la transcription de la conférence quand d’autres se contentaient de la couverture secondaire.
Étape 2, brief et plan : Opus 5 suffit. Structurer un plan à partir de sources fournies ne mobilise pas les capacités qui distinguent Fable 5.1, et vous payez deux fois moins cher par token. Étape 3, rédaction : Opus 5 par défaut, Fable 5.1 pour les pages où la qualité rédactionnelle est décisive. Canva, partenaire d’accès anticipé, cite l’écriture comme le point saillant de Fable 5.1 et rapporte une meilleure adhérence à ses consignes rédactionnelles en tests à l’aveugle. Si vous avez un guide de style de marque strict, c’est l’argument le plus solide pour Fable 5.1 sur cette étape.
Étape 4, contrôle qualité : étape non négociable et non déléguable au modèle qui a rédigé. Contrôle de similarité contre les sources, vérification que chaque chiffre est attribué, contrôle de la structure extractible. Étape 5, publication et mesure : publication vers le CMS, puis mesure des citations moteur par moteur. Un article qui ranke sur Google et qui n’est jamais cité par ChatGPT ou Perplexity a un problème de structure, pas de fond.
Sur la structure justement, la règle qui compte le plus pour le GEO est la réponse directe en tête de section, et les leviers complets sont détaillés dans comment être cité par ChatGPT.

- Recherche : Fable 5.1, effort élevé ou très élevé
- Brief, plan et rédaction courante : Opus 5
- Contrôle qualité : jamais le modèle qui a rédigé
- Mesure : moteur par moteur, jamais un score global
Ce qui s’améliore vraiment, chiffré
Ces scores sont auto-déclarés par Anthropic, mesurés avec les garde-fous de production activés. Nous n’avons retenu que les épreuves pertinentes pour du travail de contenu et de recherche.
Lisez ce tableau honnêtement. Sur le travail de connaissance, qui est la colonne la plus proche de la production de contenu, l’écart entre Fable 5.1 et Opus 5 est de 29 points Elo, soit environ 1,6 %, pour un prix par token deux fois supérieur. Sur l’épreuve de raisonnement avec outils, l’écart est de 1,4 point. Le saut spectaculaire est ailleurs : sur la recherche scientifique agentique et les workflows métier, c’est-à-dire des tâches longues et outillées, pas de la rédaction.
C’est exactement pour cette raison qu’Anthropic recommande de partir d’Opus 5. Le détail de l’arbitrage, coût par article compris, est dans Fable 5.1 vs Opus 5 pour le contenu.
| Épreuve | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Travail de connaissance (GDPval-AA v2, Elo) | 1853 | 1723 | 1824 | 1711 |
| Raisonnement multidisciplinaire (HLE, avec outils) | 65,0 % | 63,8 % | 63,6 % | Non publié |
| Raisonnement multidisciplinaire (HLE, sans outils) | 60,9 % | 57,8 % | 56,6 % | Non publié |
| Workflows métier (AutomationBench) | 31,4 % | 17,1 % | 26,9 % | 19,6 % |
| Recherche scientifique agentique (Terminal-Bench-Science 0.1) | 52,6 % | 24,7 % | 29,0 % | 22,4 % |
Les limites à connaître avant de basculer votre production
Cinq limites, dont deux peuvent être éliminatoires selon votre contexte. Le multilingue est à l’identique : Anthropic précise que les performances multilingues sont au niveau de Fable 5, sans amélioration. Si vous produisez en français, ne comptez pas sur ce modèle pour un gain de qualité linguistique. Lors de l’édition de fichiers texte, le modèle est plus susceptible de réécrire tout le fichier que de faire une modification ciblée : résultat identique le plus souvent, mais plus de tokens de sortie facturés à 50 $ le million.
Fable 5.1 est un Covered Model et n’est pas disponible sous accord de zéro rétention, sauf autorisation expresse d’Anthropic ; ses données sont conservées 30 jours. Opus 5, lui, est disponible sous zéro rétention aujourd’hui. Les nouveaux garde-fous cyber déclenchent environ 60 % moins souvent par session dans Claude Code, et les garde-fous biologie 85 % moins souvent sur les questions bénignes, mais certaines catégories de requêtes restent redirigées vers les modèles Opus : une chaîne de production doit traiter le refus comme un chemin d’erreur normal. Enfin, ni Fable 5.1 ni Mythos 5.1 ne sont supportés sur Priority Tier, contrairement à Fable 5. Les deux sources officielles d’Anthropic divergent sur ce point : faites confirmer le régime applicable avant tout engagement contractuel.
Le détail des trois ruptures d’API, avec les correctifs exacts, est dans notre guide de migration vers Fable 5.1.
- Multilingue au niveau de Fable 5, sans gain
- Réécritures de fichiers entières, facturées en sortie
- Rétention 30 jours, pas de zéro rétention par défaut
- Pas de Priority Tier, contrairement à Fable 5
Automatiser ce flux plutôt que le tenir à la main
Tout ce qui précède est faisable manuellement, et devient ingérable au-delà de quelques articles par mois. Le routage entre Opus 5 et Fable 5.1 selon la complexité de l’étape, le contrôle de similarité contre les sources, la calibration de l’effort, la structure extractible imposée à chaque section, la mesure des citations sur six moteurs : ce sont six chantiers distincts qui doivent tourner ensemble et chaque semaine.
C’est précisément ce que GetRerank fait tourner dans un seul flux : analyse du site, plan de contenu, rédaction avec routage du modèle selon la tâche, maillage interne décidé avant rédaction, publication vers votre CMS, puis mesure de Google et des six moteurs IA côte à côte. La différence avec un abonnement API brut n’est pas le modèle utilisé, c’est le fait que les garde-fous éditoriaux sont dans le flux plutôt que dans votre tête.
Sources et méthode de vérification
Publications officielles Anthropic, vérifiées le 2 septembre 2026 : l’annonce du lancement de Claude Fable 5.1 et Claude Mythos 5.1, la page de nouveautés de Fable 5.1 dans la documentation Claude Platform, le guide de migration, la system card Fable 5.1 et Mythos 5.1, la note sur le fonctionnement du watermark texte, et le Code de bonnes pratiques de l’EU AI Act sur la transparence des contenus générés par IA.
Presse : 9to5Mac et MacRumors du 1er septembre 2026. Retours de partenaires d’accès anticipé cités dans l’annonce Anthropic, non vérifiés indépendamment : Canva sur la qualité rédactionnelle, Samaya sur l’ancrage dans les sources primaires.
La règle appliquée dans cet article : tout score de benchmark est attribué à Anthropic, qui l’a mesuré sur ses propres harnais, et aucun retour partenaire n’est présenté comme une mesure indépendante.
Questions fréquentes
Faut-il utiliser Fable 5.1 pour rédiger tous ses articles ?
Non, et Anthropic le déconseille. Sa documentation recommande de commencer par Opus 5 pour la plupart des charges, et de réserver Fable 5.1 au raisonnement exigeant et au travail agentique long. Sur le travail de connaissance, l’écart mesuré est de 1,6 % pour un prix double. Réservez Fable 5.1 à la phase de recherche et aux pages à fort enjeu.
Le watermark rend-il mon contenu détectable par Google ?
Rien n’indique que Google y ait accès. Le watermark est statistique, invisible sans l’API de détection, et cette API est en préversion privée réservée à des catégories d’organisations définies par l’EU AI Act. Le vrai sujet n’est pas la détection par un moteur, c’est la conformité de vos engagements contractuels envers vos clients.
Comment éviter les citations non marquées dans les résumés ?
Par un contrôle automatisé, pas par un prompt. Exigez dans le prompt que toute reprise littérale soit entre guillemets et sourcée, puis ajoutez une vérification de similarité entre le brouillon et les sources fournies. C’est le seul garde-fou fiable sur un comportement que le modèle a par défaut.
La prochaine étape
Appliquez cette méthode à votre site, puis mesurez le même périmètre chaque semaine.
Partager
À propos de l’auteur
Contenu écrit et vérifié par l’équipe GetRerank, à partir de données produit réelles et de sources publiques citées dans l’article. Aucun résultat client n’est utilisé comme preuve.