Migrer de Claude Fable 5 ou Opus 5 vers Fable 5.1 : breaking changes et optimisations
Les trois ruptures d’API de Claude Fable 5.1, les trois changements de comportement silencieux et la checklist complète, avec les correctifs exacts depuis Fable 5 et depuis Opus 5.
Publié le :

 Claude Fable 5.1Analyse de la documentation Anthropic
En bref
Cet article s’adresse à vous si vous avez du code en production qui appelle l’API Claude Messages et que vous envisagez de passer à « claude-fable-5-1 », sorti le 1er septembre 2026. Il liste les trois ruptures d’API, les trois changements de comportement, et les correctifs exacts, avec les différences selon que vous venez de Fable 5 ou d’Opus 5. Si vous hésitez encore sur l’intérêt de migrer, lisez d’abord le comparatif Fable 5.1 vs Opus 5. Pour la vue d’ensemble du modèle, voir Claude Fable 5.1 : ce qui change vraiment.
- Trois ruptures d’API : le forçage d’appel d’outil renvoie une erreur 400, les blocs de raisonnement ne sont plus lisibles par les modèles antérieurs, et modifier un tour antérieur invalide les blocs suivants.
- La vérification d’historique ne s’applique aujourd’hui qu’aux comptes créés le 31 août 2026 ou après. Anthropic annonce l’étendre à tous les comptes sur les futurs modèles.
- Trois changements de comportement ne renvoient aucune erreur : moins d’appels d’outils en parallèle, moins de messages de progression, moins de recherche à effort bas.
- Si vous venez d’Opus 5, sept points s’ajoutent, dont l’impossibilité de désactiver la réflexion et la rétention obligatoire de 30 jours.
- L’API, les limites, le tokenizer, la gestion des refus et le comptage de tokens sont identiques à Fable 5. Le reste de la migration se joue dans la construction du tableau de messages.
Demander à l’IA de résumer cet article :
La réponse courte
La migration est presque immédiate, sauf trois choses. L’API, les limites, le tarif par token, le tokenizer, la réflexion adaptative toujours active, la gestion des refus et les catégories d’arrêt sont identiques à Fable 5. Ce qui casse : le forçage d’appel d’outil renvoie une erreur 400, les blocs de raisonnement ne sont plus lisibles par les modèles antérieurs, et modifier un tour antérieur invalide les blocs de raisonnement suivants.
Le troisième point est celui qui va surprendre le plus de monde, et il ne concerne pas tout le monde de la même façon selon la date de création de votre compte.
Si vous utilisez Claude Managed Agents, aucun changement au-delà du nom du modèle n’est nécessaire. Si vous construisez vous-même votre tableau de messages, lisez la suite en entier.
Rupture 1 : le forçage d’appel d’outil n’est plus supporté
Sur « claude-fable-5-1 », le choix d’outil accepte le mode automatique, qui est le défaut, et le mode aucun. Les valeurs qui imposent un outil renvoient une erreur 400, avec un message explicite indiquant que ces types ne sont pas supportés pour ce modèle. La vérification s’applique aussi à l’API Message Batches et au point de terminaison de comptage de tokens.
La raison technique est intéressante : la réflexion est toujours active sur ce modèle, et un appel d’outil forcé la contournerait. Le modèle écrirait alors son raisonnement dans les arguments de l’outil, ce qui dégrade leur qualité.
Trois remplacements, selon votre besoin réel. Si vous forciez un outil pour obtenir du JSON conforme à un schéma, passez aux sorties structurées, ou gardez le mode automatique et déclarez l’outil en mode strict. Attention : dans une organisation CMEK, les sorties structurées et le mode strict ne sont pas disponibles sur les modèles Fable, il faut alors s’appuyer sur l’instruction seule.
Si vous forciez un outil pour que le modèle appelle plutôt que réponde en texte, nommez l’outil dans l’instruction utilisateur : la documentation indique que Fable 5.1 suit fiablement les instructions explicites d’outil. Et si c’est votre application, et non l’utilisateur, qui exige un appel précis sur le tour courant, ajoutez un message système en cours de conversation après le dernier tour utilisateur, en nommant l’outil et en demandant au modèle d’ouvrir sa réponse par cet appel. L’avantage sur une réécriture du prompt système : les tours antérieurs restent identiques octet pour octet et conservent leurs correspondances de cache.
- JSON conforme à un schéma : sorties structurées ou mode strict
- Appel plutôt que texte : nommer l’outil dans l’instruction
- Exigence applicative : message système en cours de conversation
- En organisation CMEK, ni sorties structurées ni mode strict
Rupture 2 : les blocs de raisonnement sont liés au modèle qui les a produits
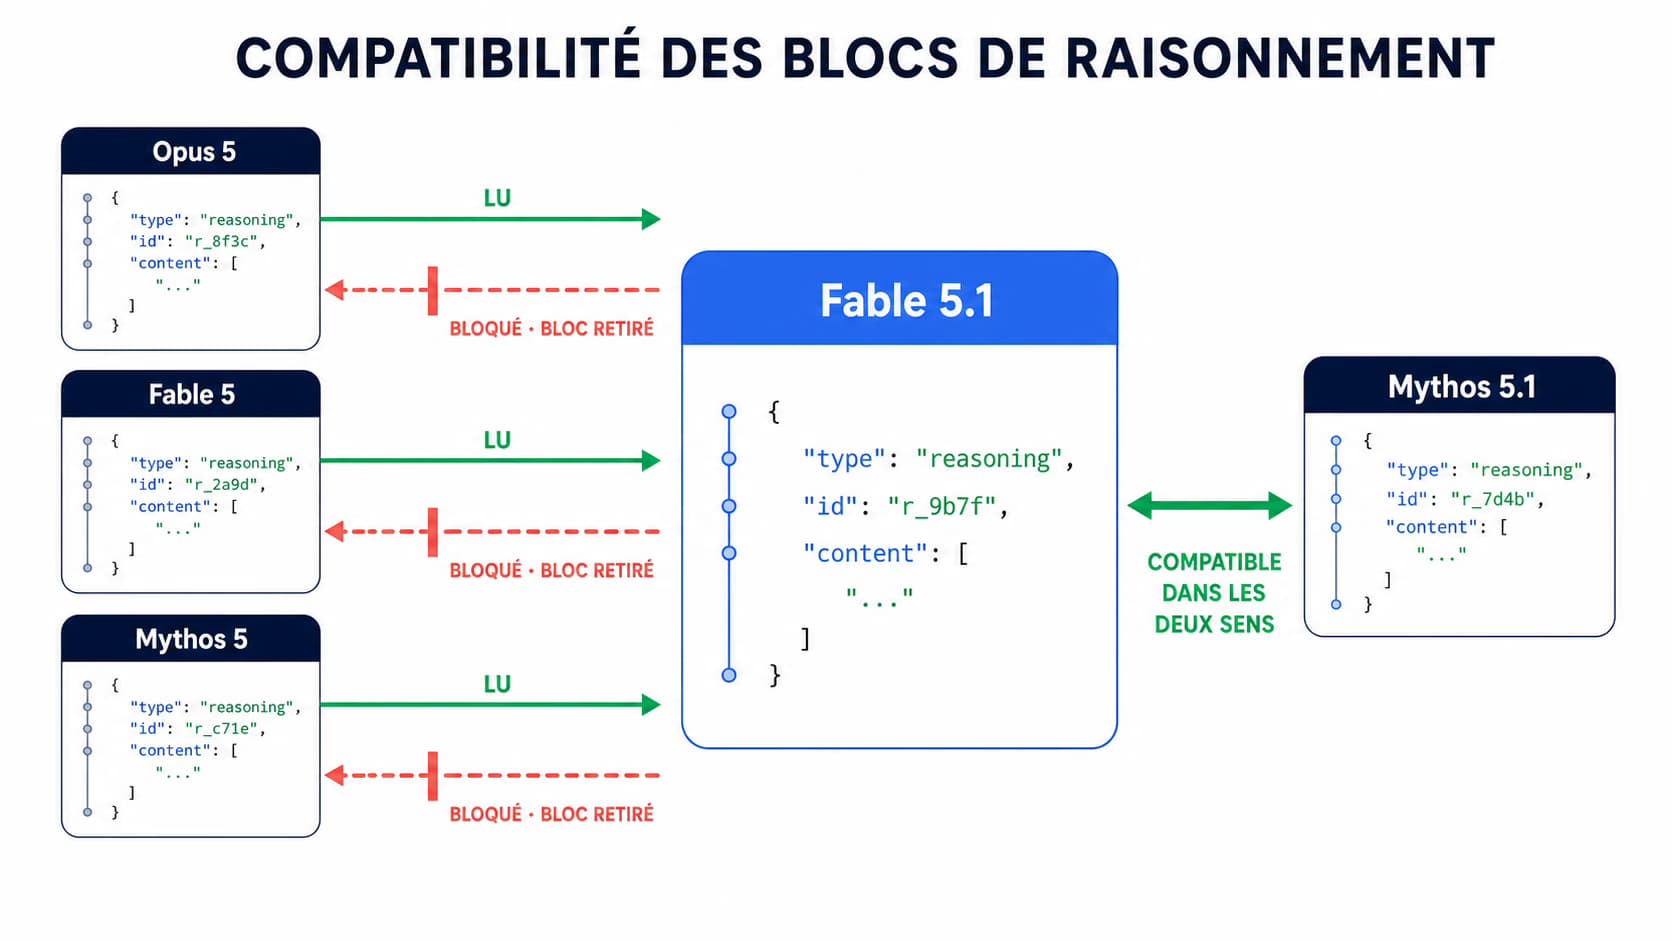
Chaque bloc de réflexion enregistre le modèle qui l’a produit, et la préservation est à sens unique. Fable 5.1 lit ses propres blocs et ceux de Mythos 5.1, Opus 5, Fable 5, Mythos 5 et des modèles antérieurs. Aucun de ces modèles, à l’exception de Mythos 5.1, ne peut lire les blocs de Fable 5.1.
En pratique, une conversation qui monte vers « claude-fable-5-1 » conserve son raisonnement. Une conversation qui redescend vers un modèle antérieur le perd, et c’est le cas qui pose problème, parce qu’il arrive sans que vous le décidiez : bascule de routeur, nouvelle tentative côté client, ou repli après un refus de classifieur, y compris un repli côté serveur.
Le comportement est propre mais silencieux. L’API retire les blocs illisibles avant que le modèle les voie, la requête réussit, et vous n’êtes pas facturé pour les tokens d’entrée supprimés. Le modèle cible replanifie sans ce raisonnement, ce qui peut augmenter le coût et la latence du premier tour après la bascule.
Pour voir ce qui a été supprimé, envoyez l’en-tête bêta de contrôle de liaison du raisonnement. Les réponses portent alors un tableau de transformations d’entrée nommant chaque bloc supprimé avec son motif. Sans cet en-tête, la suppression est totalement silencieuse. Si vous exploitez un routeur multi-modèles, activez cet en-tête : c’est votre seule visibilité.
Rupture 3 : modifier l’historique invalide les blocs de raisonnement
C’est le changement le plus profond, et celui qui touche le plus d’intégrations existantes. Chaque bloc de réflexion produit par Fable 5.1 n’est valide que contre le prompt système, les outils et l’historique de conversation qui le précédaient. Si l’un des trois change, le bloc devient invalide.
La date qui décide si ça vous concerne aujourd’hui
L’API applique la vérification pour les comptes créés le 31 août 2026 ou après. Pour les comptes plus anciens, l’API enregistre l’incohérence mais n’agit pas, sauf si la requête définit explicitement le comportement en cas d’incohérence de préfixe, ce qui revient à activer volontairement la vérification.
Anthropic annonce vouloir l’appliquer à tous les comptes sur les futurs modèles. Deux conséquences pratiques. Votre code peut fonctionner aujourd’hui et casser au prochain modèle : rendez-le compatible maintenant. Et si vous publiez un outil ou un framework que d’autres exécutent avec leur propre clé API, testez avec le champ activé, car votre clé est probablement sur un compte ancien et vos utilisateurs sur des comptes récents rencontreront l’erreur avant vous.
Pour savoir si votre compte est concerné par défaut : envoyez une requête qui modifie l’historique sans l’en-tête bêta. Une erreur 400 qui nomme l’en-tête signifie que la vérification est active.
Les patterns qui cassent, et par quoi les remplacer
Ce qui continue de fonctionner : les historiques strictement additifs, la suppression de blocs de raisonnement en tête de série du plus ancien au plus récent, le changement d’effort ou de nombre maximal de tokens, le déplacement des marqueurs de cache, et la compaction ou l’édition de contexte côté serveur. Ces deux dernières ne comptent pas comme des modifications, parce que la vérification compare la conversation telle que vous l’avez envoyée.
Un piège précis à retenir : retirer un bloc de raisonnement ailleurs qu’en tête de série invalide tous les blocs suivants.
| Ce que fait votre code | Effet | Remplacement |
|---|---|---|
| Éditer, réordonner ou supprimer un tour antérieur | Invalide tous les blocs suivants | Compaction ou édition de contexte côté serveur |
| Supprimer d’anciens résultats d’outil au milieu du transcript | Invalide tous les blocs suivants | Effacement des résultats d’outil via l’édition de contexte |
| Injecter un rappel par tour puis le retirer | Invalide tous les blocs suivants | Message système à portée de tour, laissé dans l’historique |
| Reconstruire le prompt système entre deux requêtes | Invalide tous les blocs suivants | Message système en cours de conversation portant la nouvelle instruction |
| Ajouter ou retirer un outil en cours de session | Invalide tous les blocs suivants | Blocs d’ajout et de retrait d’outil, en bêta |
| Compaction côté client qui garde les derniers tours verbatim | Invalide les blocs de ces tours | Retirer les blocs de réflexion de ces tours |
| URL d’image servant des octets différents plus tard | Invalide les blocs suivants | Envoyer via l’API Files et référencer par identifiant |
Le test en trois étapes avant de basculer le trafic
Étape 1 : capturez les corps de requête exacts sur quelques tours normaux, en incluant une compaction et un changement d’outil si votre produit en a. Pour chaque paire de requêtes consécutives, comparez le prompt système, le tableau d’outils et le préfixe partagé des messages. Ils doivent être identiques octet pour octet jusqu’aux tours nouvellement ajoutés.
Étape 2 : lancez une session multi-tours contre « claude-fable-5-1 » avec l’en-tête bêta de contrôle de liaison et le comportement de suppression de bloc, en journalisant les transformations d’entrée sur chaque réponse. Un tableau vide à chaque tour signifie que l’historique est intact. Une incohérence de préfixe signale une modification en amont du bloc. Une incohérence de modèle signale une bascule, ce qui n’est pas un bug de votre code.
Étape 3 : choisissez un réglage de production. Laissez l’erreur par défaut si une incohérence ne peut signifier qu’un bug chez vous, ou mettez la suppression de bloc pour supprimer les blocs concernés plutôt qu’échouer. Surveillez les erreurs 400 ou les transformations d’entrée dans les deux cas. En intégration continue, laissez l’erreur pour qu’une modification fasse échouer le build.
Un point de coût à ne pas manquer : supprimer des blocs de raisonnement une fois, à une frontière de compaction, a peu d’effet. Une intégration qui invalide le raisonnement antérieur à chaque requête redémarre le cache de prompt à chaque fois, ce qui peut augmenter significativement le coût par tâche.
Trois changements de comportement, sans erreur ni alerte
Ceux-là ne renvoient aucune erreur. Ils dégradent silencieusement le coût ou l’expérience.
Moins d’appels d’outils en parallèle. Dans les boucles longues où les lectures indépendantes suivantes ne sont qu’implicites, Fable 5.1 peut émettre un seul appel d’outil par tour là où Fable 5 en groupait plusieurs. Chaque tour supplémentaire coûte des tokens, un aller-retour et du temps réel, sans dégrader la qualité de la réponse. Le correctif : une instruction de regroupement d’une phrase, ajoutée après chaque message utilisateur en message système à portée de tour, laissée dans l’historique sur les requêtes suivantes.
Moins de messages de progression. Le modèle écrit moins de mises à jour d’état pendant les longues séquences d’outils, surtout à effort élevé, et ses résumés de codage agentique sont plus courts. Si votre interface affiche ces messages, réglez l’affichage du raisonnement sur le mode mises à jour pour recevoir les messages en texte tout en gardant le raisonnement masqué. Retirez aussi toute ligne de prompt qui demandait au modèle de garder ses observations pour la réponse finale.
Moins de recherche à effort bas. À effort bas, Fable 5.1 répond de mémoire plus souvent au lieu d’appeler un outil de recherche. Si votre produit dépend de la récupération à effort bas, montez l’effort pour ces requêtes ou dites explicitement au modèle quand chercher. L’effet sur la fraîcheur d’un contenu éditorial est détaillé dans utiliser Fable 5.1 pour le SEO et le GEO.
- Un appel d’outil par tour au lieu de plusieurs groupés
- Moins de mises à jour d’état pendant les séquences longues
- Réponses de mémoire plus fréquentes à effort bas
- Aucune erreur renvoyée : ces trois-là se voient à la facture
Le delta supplémentaire si vous venez d’Opus 5
Appliquez tout ce qui précède, puis ces sept points en plus.
Premièrement, la réflexion ne peut plus être désactivée. Opus 5 accepte de la désactiver à effort élevé ou moins. Sur « claude-fable-5-1 », la réflexion adaptative est toujours active et ce champ renvoie une erreur 400 à tous les niveaux d’effort. Retirez-le, contrôlez la dépense par des niveaux d’effort plus bas, et revoyez le nombre maximal de tokens pour les charges qui tournaient sans réflexion. Deuxièmement, le forçage d’outil, comme ci-dessus. Troisièmement, les blocs de raisonnement, comme ci-dessus, avec un point important : Opus 5 ne se plaignait pas quand votre code éditait l’historique, alors que Fable 5.1 le rejette ou le supprime. Faites le test en trois étapes avant de basculer le trafic.
Quatrièmement, le texte entre appels d’outils change de forme. Sur Opus 5, il revient en blocs de texte. Sur « claude-fable-5-1 », cette narration revient en blocs de réflexion, un avant chaque appel d’outil, et sous l’affichage par défaut ils ne contiennent aucun texte lisible. Cinquièmement, les classifieurs sont plus larges : Opus 5 n’a que des classifieurs cybersécurité, attendez-vous à des catégories d’arrêt au-delà du cyber, comme la biologie et l’extraction de raisonnement.
Sixièmement, le tarif : 10 $ et 50 $ par million de tokens contre 5 $ et 25 $, les lectures de cache étant à 0,25 $, soit la moitié du tarif d’Opus 5. Septièmement, la rétention : Fable 5.1 et Mythos 5.1 exigent une rétention de 30 jours et ne sont pas disponibles sous zéro rétention sauf autorisation expresse, alors qu’Opus 5 l’est, selon la documentation développeur ; l’annonce dit autre chose, et la divergence n’est pas tranchée. Vérifiez l’éligibilité de votre organisation avant de changer l’identifiant du modèle, sinon la requête renvoie une erreur 400.
- Réflexion non désactivable, le champ renvoie une erreur 400
- Narration entre outils en blocs de réflexion, pas en texte
- Classifieurs élargis au-delà de la cybersécurité
- Tarif doublé et rétention 30 jours obligatoire
Cinq optimisations qui baissent la facture
Non obligatoires, mais chacune retire un coût ou un mode de panne.
Changer l’effort en cours de conversation. Sur Fable 5, l’effort est au niveau de la requête, et le modifier entre deux requêtes fait tomber les préfixes en cache. Sur Fable 5.1, un message système portant uniquement la configuration de sortie monte l’effort pour une étape difficile ou le baisse pour les étapes routinières sans invalider le cache.
Utiliser le repli automatique pour les refus. Continuez de traiter le motif d’arrêt et de lire sa catégorie avant le contenu de la réponse. Avec le repli par défaut, une requête refusée est rejouée sur le modèle recommandé pour cette catégorie. Les cibles autorisées pour Fable 5.1 sont Opus 4.8 et Opus 5, et le modèle de repli ne reçoit pas les blocs de raisonnement de Fable 5.1.
Refaire un balayage d’effort en partant du niveau élevé, car les gains de Fable 5.1 sont les plus marqués aux niveaux supérieurs mais ces niveaux allongent le délai avant première réponse. Déplacer la réduction de contexte côté serveur : si votre code tronque ou résume les tours anciens côté client, le correctif le plus simple est de passer à la compaction ou à l’édition de contexte côté serveur, ni l’une ni l’autre ne comptant comme une modification. Et ne jamais découper un tour au milieu du transcript, ce qui invalide tous les blocs suivants sans qu’aucune forme de compaction côté client ne l’évite.
- Effort modifiable en cours de conversation, cache préservé
- Repli automatique sur Opus 4.8 ou Opus 5 après un refus
- Balayage d’effort refait, jamais repris de Fable 5
- Réduction de contexte déplacée côté serveur
La checklist de migration
Dans l’ordre, en commençant par les deux points qui provoquent des erreurs 400 en production. Changez l’identifiant de « claude-fable-5 » ou « claude-opus-5 » vers « claude-fable-5-1 », puis vérifiez l’éligibilité à la rétention 30 jours si votre organisation a un accord de zéro rétention. Remplacez tout forçage d’outil par le mode automatique plus une instruction explicite et des outils en mode strict, ou par des sorties structurées. Retirez toute désactivation de la réflexion si vous venez d’Opus 5, et revoyez le nombre maximal de tokens.
Ensuite, la partie qui touche à la construction des messages. Continuez à renvoyer les blocs de réflexion inchangés à chaque tour, y compris les blocs vides. Si votre code construit le tableau de messages, exécutez le test en trois étapes et corrigez chaque incohérence de préfixe. Rendez l’historique strictement additif : figez le prompt système et les outils au démarrage de session, déplacez les changements vers des messages système, référencez les fichiers inter-tours par identifiant. Choisissez un comportement de production en cas d’incohérence et surveillez-le.
Enfin, les réglages. Vérifiez les boucles d’agent pour le comportement à un appel d’outil par tour et ajoutez l’instruction de regroupement. Réglez l’affichage du raisonnement si votre interface montre la narration entre appels d’outils. Traitez les refus et envisagez le repli automatique. Refaites un balayage d’effort et rebasez le coût et la latence sur vos propres charges.
Pour publier ensuite vers votre CMS sans copier-coller, voir la publication par webhook.
- Identifiant de modèle, puis éligibilité à la rétention
- Forçage d’outil retiré, réflexion non désactivée
- Historique strictement additif, test en trois étapes
- Balayage d’effort et rebasage du coût sur vos charges
Pourquoi cette vérification existe : le contexte anti-distillation
La troisième rupture n’est pas un choix d’architecture, c’est une mesure de sécurité, et Anthropic l’explique dans son annonce. La distillation consiste à extraire les capacités d’un modèle avancé, souvent à l’échelle industrielle avec des milliers de faux comptes, pour les rediffuser sans garde-fous équivalents.
Une technique publiquement documentée consistait précisément à modifier manuellement le contexte antérieur de Claude dans une conversation multi-tours tout en préservant le transcript de son raisonnement. Fable 5.1 ferme cette voie. C’est pour cette raison que la vérification s’applique aux nouveaux comptes API et qu’Anthropic annonce l’étendre à tous les comptes sur les futurs modèles.
Autrement dit : ce n’est pas une régression temporaire à contourner, c’est la nouvelle norme. Une intégration qui construit son historique en mode additif est celle qui survivra aux prochaines versions, et c’est accessoirement celle qui garde le cache de prompt chaud.
Sur ce que Google sanctionne réellement dans un flux automatisé, voir contenu IA et pénalité Google.
Sources et méthode de vérification
Publications officielles Anthropic, vérifiées le 2 septembre 2026 : le guide de migration de Claude Platform, source principale de cet article, la page de nouveautés de Fable 5.1, l’annonce officielle et sa section sur les mécanismes anti-distillation, l’article du centre d’aide sur le changement de contexte multi-tours, la vue d’ensemble des modèles et tarifs, et la note Enterprise Frontier Safeguards.
Les pages de documentation citées dans l’article sont toutes sous le domaine de la plateforme Claude : raisonnement préservé, refus et repli, effort, messages système en cours de conversation, mode strict, sorties structurées, compaction, édition de contexte, mise en cache de prompt, API Files, en-têtes bêta.
Aucun comportement décrit ici n’a été mesuré par nos soins sur un compte de production. Ce sont les comportements documentés par Anthropic au 2 septembre 2026, à revérifier après chaque mise à jour de la documentation.
Questions fréquentes
Mon code fonctionne aujourd’hui, dois-je vraiment changer quelque chose ?
Probablement oui. Si votre compte API a été créé avant le 31 août 2026, la vérification d’historique enregistre les incohérences sans agir, donc votre code peut passer sans erreur tout en accumulant une dette. Anthropic annonce l’appliquer à tous les comptes sur les futurs modèles. Faire le test en trois étapes maintenant coûte une demi-journée ; le découvrir au prochain lancement coûte un incident de production.
Comment savoir si mon intégration modifie l’historique ?
Lancez une session multi-tours avec l’en-tête bêta de contrôle de liaison et le comportement de suppression de bloc, puis journalisez les transformations d’entrée sur chaque réponse. Un tableau vide à chaque tour signifie que votre historique est intact. Ce test fonctionne depuis n’importe quel compte, puisque définir ce champ active volontairement la vérification.
Que se passe-t-il si un refus fait basculer ma conversation vers Opus 5 ?
L’API supprime les blocs de raisonnement de Fable 5.1 avant que le modèle les voie, la requête réussit, et vous n’êtes pas facturé pour les tokens supprimés. Le modèle de repli replanifie sans ce raisonnement, ce qui peut augmenter le coût et la latence du premier tour après la bascule. Activez l’en-tête bêta pour voir ces suppressions, sinon elles sont silencieuses.
Mythos 5.1 se migre-t-il de la même façon ?
Presque. Le delta d’API est le même, à une exception près : Mythos 5.1 n’exécute pas la vérification de conversation, donc modifier des tours antérieurs n’invalide pas ses blocs de raisonnement. Cela redémarre quand même le cache de prompt, donc l’historique additif reste la bonne pratique.
La prochaine étape
Appliquez cette méthode à votre site, puis mesurez le même périmètre chaque semaine.
Partager
À propos de l’auteur
Contenu écrit et vérifié par l’équipe GetRerank, à partir de données produit réelles et de sources publiques citées dans l’article. Aucun résultat client n’est utilisé comme preuve.