Gemini 3.8 Flash est disponible : prix, score DeepSWE et ce que ça change
Gemini 3.8 Flash est déployé sur Gemini, Google AI Studio et les API. 71 % sur DeepSWE 1.1 contre 74 % pour Claude Opus 5, à 0,75 $ en entrée et 3,75 $ en sortie jusqu’à fin 2026.
Publié le : Mis à jour le :
- ChatGPT
- Gemini
- AI Mode
- Claude
- Perplexity
- Grok
En bref
Gemini 3.8 Flash est déployé depuis ce mercredi 2 septembre 2026 sur l’application Gemini, sur Google AI Studio et sur les API. Le modèle obtient 71 % sur DeepSWE 1.1, contre 74 % pour Claude Opus 5, à un prix très inférieur : 0,75 $ en entrée et 3,75 $ en sortie par million de tokens jusqu’au 31 décembre 2026. Cet article a été publié pendant la fenêtre où le modèle était visible dans la console sans qu’aucune annonce n’existe ; il est mis à jour avec les chiffres officiels, et ce qui n’était qu’observé ou rapporté reste indiqué comme tel.
- Le modèle est disponible sur l’application Gemini, Google AI Studio et les API, sous l’identifiant gemini-3-8-flash.
- 71 % sur DeepSWE 1.1 contre 74 % pour Claude Opus 5 : trois points d’écart, pour un prix par million de tokens sans comparaison.
- 0,75 $ en entrée et 3,75 $ en sortie, tokens de réflexion compris, jusqu’au 31 décembre 2026. Puis 1,50 $ et 7,50 $ au 1er janvier 2027, soit le double.
- Même tarif de lancement que 3.7 Flash, sorti trois semaines plus tôt : Google ne baisse plus le prix, il monte la capacité au même prix.
- Troisième modèle Flash en six semaines. Un routage calé sur « le Flash du moment » se réévalue chaque mois, pas chaque trimestre.
- L’action utile reste de figer une mesure de référence sur vos requêtes avant que les surfaces génératives de Google ne changent de modèle.
Demander à l’IA de résumer cet article :
C’est officiel : disponible partout, avec ses chiffres
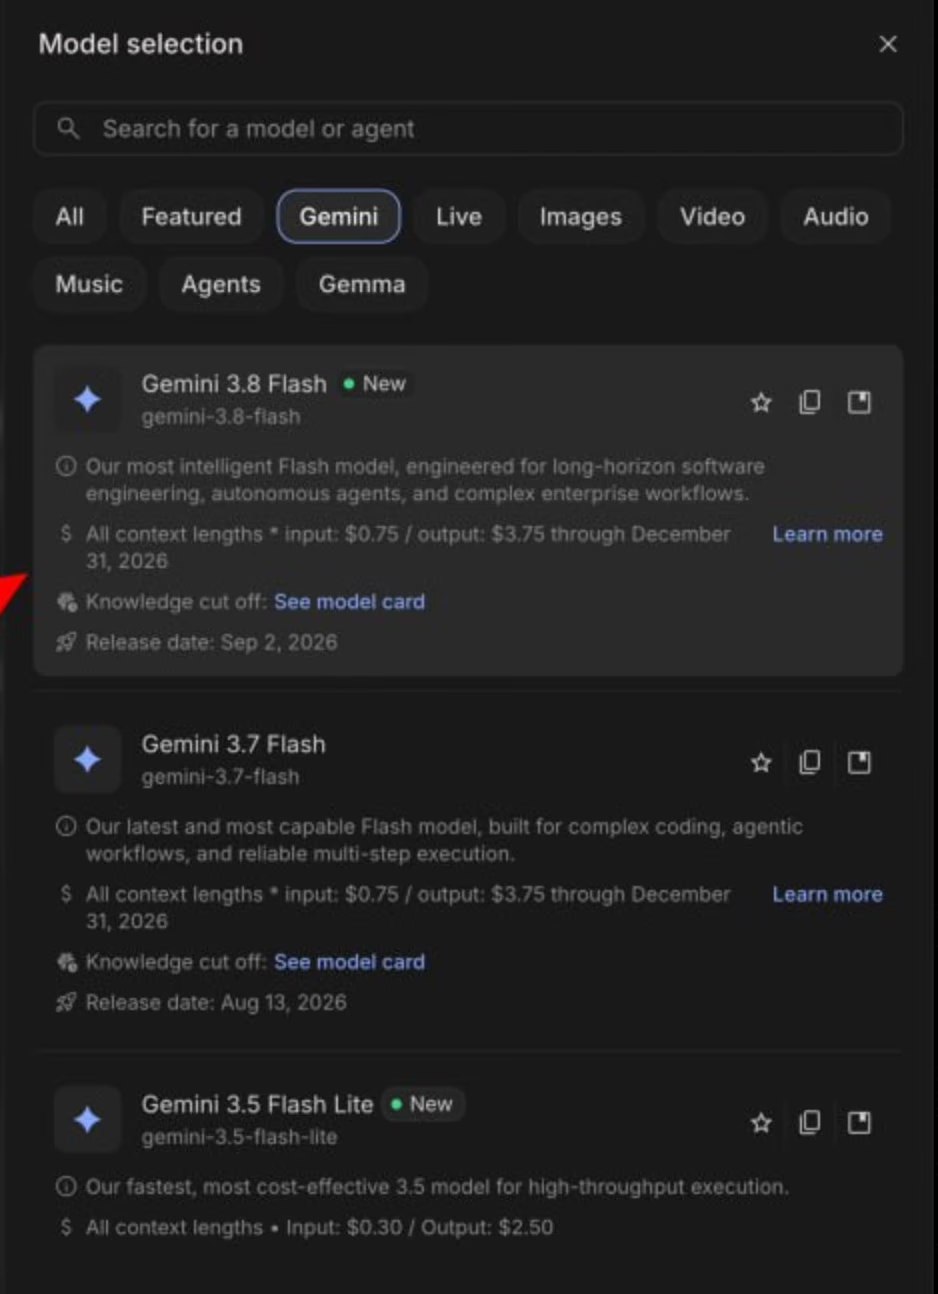
Quelques heures après l’apparition du modèle dans la console, Google a officialisé le déploiement. Gemini 3.8 Flash est disponible sur l’application Gemini, sur Google AI Studio et sur les API, sous l’identifiant gemini-3-8-flash, avec une date de sortie affichée au 2 septembre 2026. La description officielle le présente comme le modèle Flash le plus intelligent de Google, conçu pour le génie logiciel de long horizon, les agents autonomes et les flux d’entreprise complexes.
Le chiffre qui compte est le score sur DeepSWE 1.1, un banc d’essai de génie logiciel : 71 % pour Gemini 3.8 Flash, contre 74 % pour Claude Opus 5. Trois points d’écart avec le modèle le plus cher du marché, et une différence de prix qui n’a rien à voir. C’est exactement la thèse que le Wall Street Journal rapportait la veille sans chiffre : Google fait progresser sa capacité de codage par sa gamme légère.
Le prix est le même qu’au lancement de 3.7 Flash, trois semaines plus tôt, ce qui mérite d’être noté. Entre 3.6 et 3.7 Flash, Google avait divisé le tarif par deux. Cette fois il le maintient et monte la capacité. La gamme Flash ne comprime donc plus son prix chaque mois, elle donne plus pour le même prix, ce qui est un signal différent pour qui bâtit un budget.
| Période | Entrée | Sortie, tokens de réflexion compris |
|---|---|---|
| Jusqu’au 31 décembre 2026 | 0,75 $ | 3,75 $ |
| À partir du 1er janvier 2027 | 1,50 $ | 7,50 $ |
Ce que nous avions vu, avant l’annonce
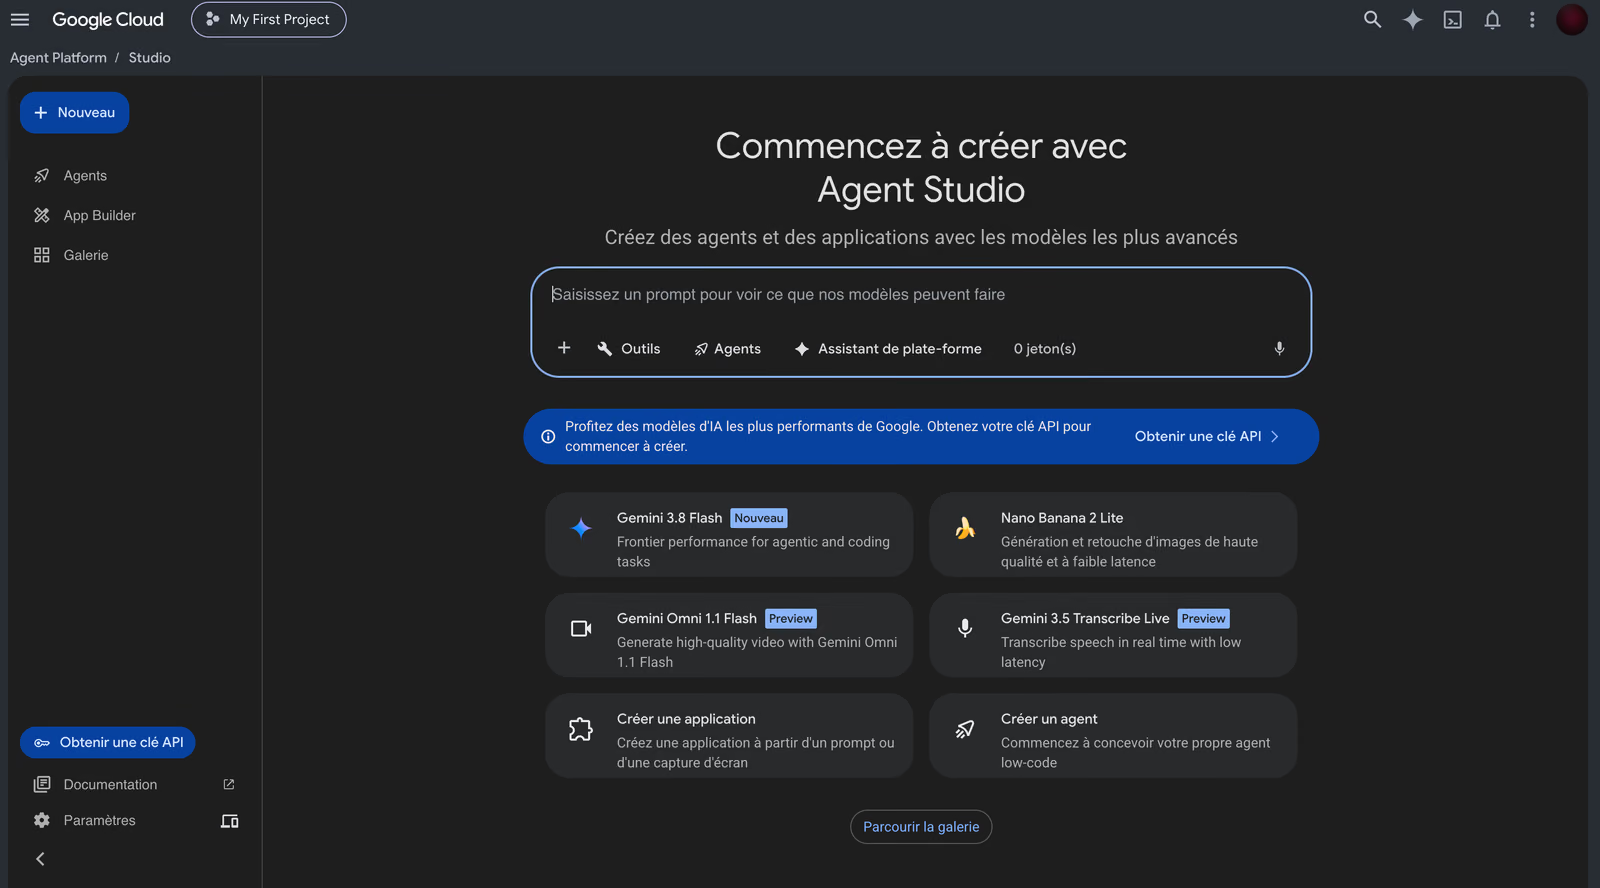
La page d’accueil d’Agent Studio, section « Agent Platform / Studio » de la console Google Cloud, affiche ce mercredi quatre cartes de modèles mis en avant. La première est Gemini 3.8 Flash, avec le badge « Nouveau » et la phrase d’accroche « Frontier performance for agentic and coding tasks ». Les trois autres sont Nano Banana 2 Lite pour l’image, Gemini Omni 1.1 Flash en préversion pour la vidéo, et Gemini 3.5 Transcribe Live en préversion pour la transcription temps réel.
Une description plus détaillée du modèle circule depuis l’interface, relayée sur X par des utilisateurs de la console. Elle positionne 3.8 Flash comme le meilleur choix pour trois familles de tâches : le traitement de données multimodales complexes, les cas d’usage de codage, et le support des tâches agentiques liées au génie logiciel. Les exemples cités sont le traitement de données mêlant images et texte, la résolution de problèmes de code, la recherche web et le test d’applications. Nous reprenons cette description telle qu’elle est relayée, sans avoir pu la confirmer sur une page de documentation publique, qui n’existe pas encore.
Ce que ça signifie concrètement : Google a poussé le modèle dans une interface de production avant d’écrire le billet de blog. Ce n’est pas inhabituel chez Google Cloud, où la console et la documentation se mettent à jour par vagues. Mais ça crée une fenêtre de quelques heures pendant laquelle le modèle est sélectionnable sans qu’aucune spécification officielle n’existe. Cet article est écrit dans cette fenêtre.
Ce que dit le Wall Street Journal
Le Wall Street Journal a rapporté le 1er septembre que Google DeepMind préparait le lancement d’un nouveau modèle « dès mercredi », ciblant précisément le développement logiciel, un domaine où Google accuse un retard sur OpenAI et Anthropic. Le rapport a été repris par Investing.com, Yahoo Finance et Quartz.
Un point de lecture important : le WSJ écrit que les ingénieurs ont « préféré » le modèle à Claude Opus sur des tests internes, sans préciser quelle version d’Opus ni quelle méthode. Plusieurs blogs ont transformé cette phrase en « parité avec Opus 5 sur les benchmarks ». Ce n’est pas ce que dit la source. Une préférence d’ingénieurs sur un outil interne n’est pas un score, et le WSJ ne cite aucun chiffre.
- Le modèle s’appelle Gemini 3.8 Flash et porte le nom de code interne « Skimaki »
- Sur Jetski, la plateforme de développement interne de Google, les ingénieurs ont préféré le nouveau modèle à Claude Opus d’Anthropic
- Google a consacré plus de ressources à l’apprentissage par renforcement depuis le début de l’année
- L’architecture plus légère des modèles Flash demande beaucoup moins de calcul à modifier, ce qui permet à plusieurs équipes de recherche d’itérer en parallèle
- La gamme Pro a connu l’inverse : des candidats internes pour Gemini 3.5 Pro abandonnés et des délais glissés de plusieurs mois
- Le prochain modèle phare, Gemini 4, terminait sa phase de post-entraînement au moment du rapport
- Le lancement intervient un mois après le retrait de Demis Hassabis de la direction quotidienne de DeepMind, remplacé par Koray Kavukcuoglu
Confirmé, rapporté, spéculé
La règle de lecture est la même que pour tout lancement non annoncé : une observation dans une console, un article de presse et une rumeur communautaire ne se citent pas de la même manière. Le tableau ci-dessous donne le statut de chaque information au 2 septembre 2026 à 16 h 13.
| Information | Statut | Source | Fiabilité |
|---|---|---|---|
| Présence dans Agent Studio avec badge « Nouveau » | Vérifié | Capture d’écran console Google Cloud, 2 septembre | Certaine |
| Positionnement « agentic and coding tasks » | Vérifié | Accroche affichée dans Agent Studio | Certaine |
| Description détaillée : multimodal, codage, agents logiciels | Relayé | Texte de la console relayé sur X, non confirmé publiquement | Élevée |
| Lancement prévu le mercredi 2 septembre | Rapporté | Wall Street Journal, 1er septembre | Élevée, cohérent avec l’observation |
| Nom de code « Skimaki » | Rapporté | Wall Street Journal | Élevée |
| Préféré à Claude Opus par des ingénieurs Google | Rapporté | Wall Street Journal, sans chiffre ni version d’Opus | Moyenne |
| « Parité avec Opus 5 sur les benchmarks » | Spéculation | Blogs secondaires interprétant le WSJ | Faible |
| Fenêtre de contexte de 1 million de tokens | Spéculation | Comptes communautaires, plausible par continuité de gamme | Moyenne |
| Prix de Gemini 3.8 Flash | Inconnu | Aucune source | Aucune |
| Benchmarks publiés | Inconnu | Aucune source | Aucune |
| Disponibilité API Gemini, AI Studio, application Gemini | Inconnu | Non observé | Aucune |
| Billet d’annonce officiel | Absent à la publication | blog.google, deepmind.google | Vérifié comme absent |
La barre à franchir : ce que fait Gemini 3.7 Flash
Pour situer 3.8 Flash, il faut partir de la fiche officielle de son prédécesseur, sortie il y a trois semaines. Ces éléments-là sont documentés par Google, contrairement à tout ce qui concerne 3.8 Flash aujourd’hui.
Deux choses à retenir pour lire la fiche de 3.8 Flash quand elle sortira. D’abord la trajectoire tarifaire : 3.7 Flash a été lancé à la moitié du prix de 3.6 Flash, et Google a explicitement présenté cette baisse comme un résultat d’améliorations algorithmiques. Si 3.8 Flash arrive au même tarif de lancement, ou plus bas, la gamme Flash continue de comprimer le coût du codage agentique à un rythme mensuel.
Ensuite la convention d’API : la famille Gemini 3 ignore les paramètres d’échantillonnage et refuse certains niveaux de réflexion. Un flux qui bascule vers 3.8 Flash doit s’attendre aux mêmes contraintes, et à d’éventuelles nouvelles.
| Caractéristique | Valeur |
|---|---|
| Date de sortie | 13 août 2026, trois semaines après 3.6 Flash |
| Positionnement | « Notre modèle workhorse le plus intelligent pour le codage et les agents » |
| Fenêtre de contexte | 1 048 576 tokens |
| Sortie maximale | 65 536 tokens |
| Entrées | Texte, image, vidéo, audio, PDF |
| Niveaux de réflexion | low, medium par défaut, high ; minimal renvoie une erreur |
| Prix de lancement | 0,75 $ / 3,75 $ par million de tokens, jusqu’au 31 décembre 2026 |
| Prix standard | 1,50 $ / 7,50 $ à partir du 1er janvier 2027 |
| Paramètres d’échantillonnage | temperature, top_k et top_p ignorés par le backend |
| Surfaces | API Gemini via AI Studio, Antigravity, Android Studio, Agent Platform, application Gemini via Spark |
Pourquoi trois Flash en six semaines
La cadence est le fait le plus important de ce lancement, plus que le modèle lui-même. Gemini 3.6 Flash a sa model card datée du 21 juillet, 3.7 Flash est sorti le 13 août, 3.8 Flash apparaît le 2 septembre. Trois itérations d’un même palier en six semaines, quand les laboratoires concurrents espacent leurs modèles de plusieurs mois.
L’explication est dans le rapport du WSJ : un modèle Flash coûte beaucoup moins cher à modifier qu’un modèle Pro, donc Google peut faire tourner plusieurs équipes d’apprentissage par renforcement en parallèle et livrer le résultat chaque mois. La gamme Pro, elle, a vu des candidats abandonnés et des délais glisser. Google fait donc progresser sa capacité de codage par la gamme légère, là où il peut itérer vite, pendant que Gemini 4 termine son post-entraînement.
Pour un décideur, la conséquence est simple : un routage de modèles calé sur « le Flash du moment » doit être réévalué chaque mois, pas chaque trimestre. Le modèle que vous avez testé en juillet n’est plus celui que Google sert en septembre, et il n’aura peut-être pas le même prix.
Ce que ça change pour le SEO et le GEO
Un modèle Flash n’est pas un événement pour votre classement Google. Il l’est pour deux choses : la manière dont Google lit le web dans ses propres surfaces génératives, et l’économie de votre production de contenu.
Google ne dit pas quel modèle alimente les Aperçus IA ni le Mode IA de la recherche. Ce qui est documenté, c’est que la gamme Flash est conçue pour le volume : latence basse, coût faible, fenêtre d’un million de tokens. C’est le profil d’un modèle qui lit des pages web par milliards. Chaque génération de Flash change donc, potentiellement, la manière dont Google extrait une réponse d’une page : ce qu’il retient, ce qu’il ignore, comment il pèse un tableau face à un paragraphe.
Ça ne se devine pas, ça se mesure. Sur vos requêtes qui déclenchent un Aperçu IA, relevez cette semaine quelles pages sont citées et quels passages sont repris. Dans quinze jours, refaites le relevé. Si les sources ont bougé sans que votre contenu ait changé, le modèle a changé. La méthode est détaillée dans notre page sur la visibilité dans les Aperçus IA de Google, et celle sur la visibilité dans Gemini couvre l’application et son mode de citation.
Le second effet passe par le prix. À 0,75 $ / 3,75 $, Gemini 3.7 Flash est déjà l’un des modèles les moins chers capables de tenir une tâche agentique. Face à lui : Claude Sonnet 5 à 2 $ / 10 $, GPT-5.6 Terra à 2 $ / 12 $ depuis les baisses du 30 juillet, Grok 4.6 à 2 $ / 6 $, et GPT-5.6 Luna à 0,20 $ / 1,20 $ mais sur un palier de capacité inférieur. Si 3.8 Flash conserve le tarif de lancement de 3.7, il devient le candidat par défaut pour les étapes de production à volume : brouillons, variantes, extraction, reformulation, métadonnées.
Le raisonnement est le même que dans notre comparatif Fable 5.1 contre Opus 5 : le bon montage n’est pas un modèle, c’est un modèle par étape. La recherche multi-étapes va au modèle qui ancre le mieux ses sources, la rédaction au meilleur rapport qualité prix, la vérification à un modèle différent de celui qui a rédigé. Un Flash à 0,75 $ a sa place dans ce montage, à condition de mesurer ce qu’il fait de vos consignes de structure.
Reste la promesse multimodale, à tester sur vos propres pages. La description relayée depuis Agent Studio met en avant le traitement de données mêlant images et texte. Pour du contenu, ça concerne trois usages concrets : la lecture de PDF et de rapports pour en extraire des chiffres sourcés, la génération de texte alternatif et de légendes à l’échelle d’un site, et l’analyse de captures d’écran de SERP ou d’interfaces. Le test à faire dès que l’API est ouverte : prenez dix pages avec des visuels, demandez au modèle d’en extraire les chiffres et de les attribuer, et comparez avec 3.7 Flash sur le même prompt.
Ce que ça ne change pas
Trois rappels, valables pour Gemini 3.8 Flash comme pour tout lancement de modèle. Votre classement organique d’abord : un modèle Flash n’intervient pas dans les signaux de classement de Google, l’effet passe par les surfaces génératives et les citations, pas par la position bleue.
Les règles de citation ensuite. Un modèle plus rapide lit mieux, il ne lit pas autre chose. Les pages datées, sourcées, structurées en réponses directes restent celles qu’un moteur génératif peut reprendre telles quelles. Notre article sur les nouveaux modèles IA détaille ce qu’une génération déplace réellement pour un site.
La relecture enfin. Le WSJ rapporte une préférence d’ingénieurs pour le codage. Rien n’est dit sur la fidélité aux sources en rédaction. Ne faites pas confiance à un modèle sur un usage pour lequel personne n’a publié de mesure.
- Aucun effet direct sur le classement organique Google
- Même besoin de pages utiles, datées et sourcées pour être cité
- Même nécessité de vérifier les chiffres avec un modèle différent de celui qui rédige
- Changement possible uniquement dans les surfaces génératives et l’économie de production
Le contexte : trois lancements frontière en 48 heures
Gemini 3.8 Flash arrive dans une séquence inhabituellement dense. Le 1er septembre, Anthropic a lancé Claude Fable 5.1 et Mythos 5.1, et OpenAI a confirmé qu’Astra franchissait son seuil de sécurité le plus élevé en annonçant une sortie « bientôt ». Le 2 septembre, Elon Musk a annoncé Grok 4.7 pour le 12, et Gemini 3.8 Flash apparaît dans Agent Studio.
Quatre laboratoires, quatre stratégies. Anthropic et OpenAI montent en capacité au sommet, avec des modèles à 10 $ / 50 $ et des accès restreints. SpaceXAI promet une taille record. Google, lui, fait progresser sa gamme légère chaque mois et laisse son modèle phare en post-entraînement. Pour un producteur de contenu, la stratégie de Google est celle qui touche le plus directement le coût par article, et celle qui exige le plus de réévaluations.
Les détails de chaque lancement : Claude Fable 5.1, OpenAI Astra et Grok 4.7.
Comment vérifier vous-même dans les prochaines heures
Cinq contrôles, dans l’ordre où les informations vont apparaître. La console est le point de départ, pas la confirmation : dans Google Cloud, ouvrez Agent Platform puis Studio, le modèle y est déjà visible avec son badge « Nouveau ».
Tout ça se fait à la main pour une veille ponctuelle. Pour une production qui doit réévaluer son routage chaque mois, c’est un flux à automatiser : le suivi des mentions IA relève ce que Google et les cinq autres moteurs citent sur vos requêtes chaque semaine, et le routage du modèle par étape se règle une fois pour l’ensemble du plan de contenu, plutôt qu’article par article à chaque lancement.
- La documentation Agent Platform : la fiche 3.8 Flash devrait suivre la structure de celle de 3.7 Flash, identifiant, modalités, limites de tokens, capacités, options de consommation
- La model card DeepMind : elle donnera le modèle de base, le prix et la date d’expiration d’un éventuel tarif de lancement, c’est la source à citer pour tout chiffre
- Le billet blog.google : c’est là que Google publiera ses benchmarks comparés à 3.7 Flash, regardez à quels concurrents il se compare et lesquels il omet
- L’identifiant API : par convention de gamme, l’identifiant attendu est gemini-3.8-flash, mais ne le déduisez pas, testez un appel et lisez le champ modèle de la réponse
- La disponibilité hors Agent Studio : API Gemini, AI Studio et application Gemini grand public, aucune n’est confirmée à cette heure
Sources et mise à jour
Observation directe : console Google Cloud, Agent Platform / Studio, capture d’écran du 2 septembre 2026 à 16 h 13 heure de Paris, Gemini 3.8 Flash listé avec badge « Nouveau » et l’accroche « Frontier performance for agentic and coding tasks ».
Presse : Wall Street Journal, 1er septembre 2026, lancement prévu « dès mercredi », nom de code Skimaki, tests internes sur Jetski. Repris par Investing.com, Yahoo Finance et Quartz le 2 septembre 2026.
Documentation officielle Google consultée pour la base de comparaison : billet d’annonce et model card de Gemini 3.7 Flash du 13 août 2026, fiches Agent Platform et API Gemini du même modèle, model card de Gemini 3.6 Flash du 21 juillet 2026, et page de tarification Agent Platform. Contexte concurrentiel : annonce Anthropic Fable 5.1 et Mythos 5.1 du 1er septembre, « Path to Astra » d’OpenAI du 1er septembre, fiche Grok 4.6 du 12 août, et baisses de prix GPT-5.6 du 30 juillet rapportées par CNBC.
Mise à jour du 2 septembre 2026, 16 h 30, publication : Gemini 3.8 Flash était visible dans Agent Studio, sans aucune communication officielle de Google. Toutes les informations sur les capacités venaient du rapport du Wall Street Journal du 1er septembre et de la description relayée depuis la console.
Mise à jour du 2 septembre 2026, 17 h 20 : Google a officialisé le déploiement sur l’application Gemini, Google AI Studio et les API. Ce qui s’est confirmé : le nom, l’identifiant gemini-3-8-flash, la date de sortie du 2 septembre, le positionnement sur le génie logiciel et les agents, et le tarif de la gamme Flash. Ce qui s’est ajouté : le score de 71 % sur DeepSWE 1.1 contre 74 % pour Claude Opus 5, et le prix confirmé à 0,75 $ en entrée et 3,75 $ en sortie jusqu’au 31 décembre 2026, puis le double au 1er janvier 2027. Ce qui ne s’est pas confirmé : la « parité avec Opus 5 sur les benchmarks » que des blogs secondaires avaient déduite du Wall Street Journal. L’écart réel est de trois points, en faveur d’Opus 5. La fenêtre de contexte reste à lire sur la model card.
Questions fréquentes
Gemini 3.8 Flash est-il officiellement sorti ?
Il est déployé sans être annoncé. Le modèle apparaît dans Agent Studio sur Google Cloud depuis le 2 septembre 2026 avec un badge « Nouveau », mais Google n’a publié ni billet, ni model card, ni tarif au moment de cet article. Le Wall Street Journal avait annoncé la veille un lancement « dès mercredi ». La communication officielle devrait suivre dans les heures qui viennent.
Quelle différence avec Gemini 3.7 Flash ?
Personne ne le sait encore : aucun benchmark comparé n’a été publié. Le WSJ décrit un modèle centré sur le codage et les agents, testé en interne contre Claude Opus. La fiche de 3.7 Flash, sortie le 13 août, donne la base de comparaison : 1 million de tokens de contexte, 65 536 tokens de sortie, 0,75 $ / 3,75 $ par million de tokens jusqu’à fin 2026.
Combien coûte Gemini 3.8 Flash ?
Le prix n’est pas publié. La trajectoire de la gamme est indicative : 3.7 Flash a été lancé à la moitié du prix de 3.6 Flash, avec un tarif de lancement valable jusqu’au 31 décembre 2026 puis un tarif standard doublé. Attendez la model card avant de budgéter, et vérifiez la date d’expiration d’un éventuel tarif promotionnel.
Faut-il basculer sa production de contenu sur Gemini 3.8 Flash ?
Pas sans mesure. Trois choses ne bougent pas avec ce lancement : votre classement Google, les règles qui font qu’une page est citée, et la nécessité de vérifier ce que le modèle produit. Ce qui peut bouger, c’est le coût de vos étapes à volume si le tarif reste bas, et la manière dont les surfaces génératives de Google lisent vos pages.
Pourquoi trois modèles Flash en six semaines ?
Parce qu’un modèle Flash coûte beaucoup moins cher à modifier qu’un modèle Pro, d’après le Wall Street Journal. Google peut donc faire tourner plusieurs équipes d’apprentissage par renforcement en parallèle sur sa gamme légère, pendant que la gamme Pro accumule les retards et que Gemini 4 termine son post-entraînement.
La prochaine étape
Appliquez cette méthode à votre site, puis mesurez le même périmètre chaque semaine.
Partager
À propos de l’auteur
Contenu écrit et vérifié par l’équipe GetRerank, à partir de données produit réelles et de sources publiques citées dans l’article. Aucun résultat client n’est utilisé comme preuve.